
(’26) 머신러닝 플랫폼 엔지니어링 책 Study에서 책 7-9장 내용을 기반으로 본인 환경에서 실습한 내용을 정리하였습니다.
책에 언급된 MLOps Flow에 대한 실습을 로컬 WSL 환경에서 CPU 기반의 실습으로 커스터마이징하여 진행하였다. KFP SDK로 실제 파이프라인을 실행하고 데이터셋, 모델, 지표, HTML 리포트를 파일로 남겼다. 두 파이프라인 모두 성공했고 테스트 정확도는 98.89%였다.
1. 실습 범위 설정
| 책에 언급된 주제 | 실습 범위 |
|---|---|
| CH7 Input/Output 아티팩트와 메타데이터 | Dataset → Model → Metrics/HTML 연결을 KFP 로컬 실행으로 확인 |
| CH8 데이터 준비, 훈련, 검증, 결과 시각화 | digits 준비 → SVC 학습 → 검증으로 C 선택 → 테스트 평가 |
CH9 공유 PVC와 .after() 의존성 |
Docker bind mount의 공유 경로와 .after()로 순서 제어 |
| YOLO 객체 탐지와 큰 이미지 데이터 | 8×8 숫자 이미지 분류로 대체 |
| Kubernetes PVC·오브젝트 스토리지·서버 UI | (생략) |
책 7–9장에 설명된 아티팩트 전달, 학습·검증, 공유 저장소 개념을 로컬 실습을 진행해 보았다. 실제 PersistentVolumeClaim을 만들거나 스케줄링·접근 모드를까지는 진행하지 않았으며, KFP 로컬 모드에서는 아티팩트도 로컬 파일이므로 네트워크 업로드와 다운로드 속도를 하지 않았다.
2. 실습 환경
이번 컴퓨터에는 WSL Ubuntu, Docker에서 book-env/runtime:0.1 이미지를 기반으로 사용하였다.
| 항목 | 실행에서 확인한 값 |
|---|---|
| Python | 3.11.18 |
| KFP SDK | 2.10.1 |
| scikit-learn | 1.5.2 |
| NumPy / pandas | 1.26.4 / 2.2.3 |
| matplotlib | 3.11.2 |
| 컨테이너 CPU / RAM 용량 | 2 CPU / 2 GiB |
| GPU / 실행 네트워크 | 미사용 / --network none |
| 실행기 | kfp.local.SubprocessRunner(use_venv=False) |
각 단계는 같은 컨테이너 안에서 별도의 Python 프로세스로 실행된다.
3. 실행 파일과 시작 명령
WSL에서 아래 명령을 실행한다.
docker image inspect book-env/runtime:0.1 --format '{{.Id}}'
bash bootstrap.shbootstrap.sh는 환경 정보를 기록하고 아래 구성으로 Python 실습 파일을 실행한다.
docker run --rm --cpus 2 --memory 2g --network none \
  --user "$(id -u):$(id -g)" \
  -e PYTHONPATH=/workspace -e MPLCONFIGDIR=/tmp/matplotlib \
  -e HOME=/tmp -e OMP_NUM_THREADS=2 -e OPENBLAS_NUM_THREADS=2 \
  -v "$PWD:/workspace" -w /workspace --entrypoint python \
  book-env/runtime:0.1 run_lab.py
WSL 경로를 $PWD로 전달하고 Docker에서는 /workspace로 읽는다. --rm으로 실행 컨테이너는 종료 후 제거되지만 bind mount에 저장한 결과는 로컬에 남는다. 원래 실행 중이던 다른 컨테이너는 건드리지 않는다.
파일 역할은 다음과 같다.
run_lab.py: 타입이 있는 KFP 컴포넌트, 두 파이프라인, 컴파일, 실행, 결과 비교.lab_steps.py: 데이터 준비, 모델 학습, 평가 구현.compiled/*.yaml: KFP가 생성한 실제 파이프라인 정의.results/kfp/: 실행별 아티팩트와executor_output.json.results/shared/: 공유 방식에서 사용하는 데이터와 모델.logs/run.log,evidence/summary.json: 원본 로그와 최종 확인 결과.
이미지 ID는 evidence/environment.txt에 기록했다. 환경 재구성 예시는 ../Dockerfile.rebuild이며, 패키지 설치를 위한 인터넷은 그때만 필요하다. 실제 실행에서는 재빌드하지 않았다.
4. 데이터 준비: 분리된 train / validation / test
load_digits()의 1,797개 샘플을 사용한다. 각 이미지의 64개 픽셀 값을 16으로 나눠 0–1 범위로 만들고, 정답 클래스 비율을 유지하는 stratify와 random_state=42를 적용했다.
먼저 75%를 train으로 떼고, 나머지 25%에서 60%를 validation, 40%를 test로 나눈다. 반올림 때문에 실제 개수는 train 1,347, validation 270, test 180이다. 각 샘플의 원래 ID를 저장해 세 집합의 교집합이 없고 전체 ID를 빠짐없이 포함하는지 assertion으로 확인했다.
train_ids, remaining = train_test_split(
    ids, test_size=0.25, stratify=digits.target, random_state=42)
val_ids, test_ids = train_test_split(
    remaining, test_size=0.4,
    stratify=digits.target[remaining], random_state=42)
train.npz, val.npz, test.npz에는 X, y, ids가 들어간다. 파일 합계는 80,247바이트다. 메타데이터에는 split, seed, 파일 크기, SHA-256을 저장했다. 픽셀 범위의 고정 상수 16으로 정규화했으므로 validation이나 test의 통계로 전처리 값을 학습하지 않는다.
5. 아티팩트를 연결하는 파이프라인
@dsl.pipeline(name="digits-artifact-pipeline")
def artifact_pipeline(seed: int = 42):
    prepared = prepare_dataset(seed=seed)
    fitted = fit_model(dataset=prepared.outputs["dataset"])
    evaluate_model(
        dataset=prepared.outputs["dataset"],
        model=fitted.outputs["model"])
데이터 준비 컴포넌트는 Output[Dataset]의 .path에 데이터를 쓴다. 학습 컴포넌트는 Input[Dataset]의 .path를 읽고 Output[Model]에 모델을 쓴다. 평가에서는 두 입력 아티팩트가 제공하는 경로를 읽는다. 이전 단계의 실제 경로를 임의의 문자열로 하드코딩하지 않는다.
파일 내용과 메타데이터는 구분해야 한다. .path 아래에는 실제 파일을 저장하고, .metadata에는 데이터 출처·해시 등을 기록한다. metrics.log_metric()으로 기록한 값은 Metrics 아티팩트의 메타데이터에 들어간다. HTML 보고서와 PNG 파일도 실제로 생성했다.
컴파일한 YAML은 정의를 확인하는 자료다. 컴포넌트가 lab_steps 모듈을 import하므로 이 YAML을 클러스터에 올릴 때는 해당 모듈을 포함한 이미지가 추가로 필요하다. 현재 코드는 로컬 /workspace 마운트와 PYTHONPATH를 사용한다.
6. 학습과 평가의 역할 분리
학습에서는 RBF SVC의 C 값을 0.1, 1.0, 10.0으로 바꿔 각각 train 데이터에 fit하고 validation 정확도로 선택했다.
| C | Validation accuracy |
|---|---|
| 0.1 | 94.81% |
| 1.0 | 99.26% |
| 10.0 | 99.26% |
최고 점수가 같아 먼저 평가한 C=1.0을 선택했다. 선택 후 train+validation으로 재학습하지 않고 선택한 train 학습 모델을 그대로 테스트했다. DummyClassifier(strategy="most_frequent")도 같은 train 데이터로 학습해 기준 성능을 만들었다.
| 테스트 결과 | 값 |
|---|---|
| SVC 정확도 | 98.89% |
| 기준 모델 정확도 | 10.00% |
| 정답 / 전체 | 178 / 180 |
| 오분류 | 2개 |
| Weighted F1 | 0.988834 |
테스트 데이터는 C를 선택하는 데 쓰지 않았다. 이 한 번의 고정 split에 대한 결과이며, 교차 검증이나 외부 데이터 일반화 성능을 검증한 결과는 아니다.
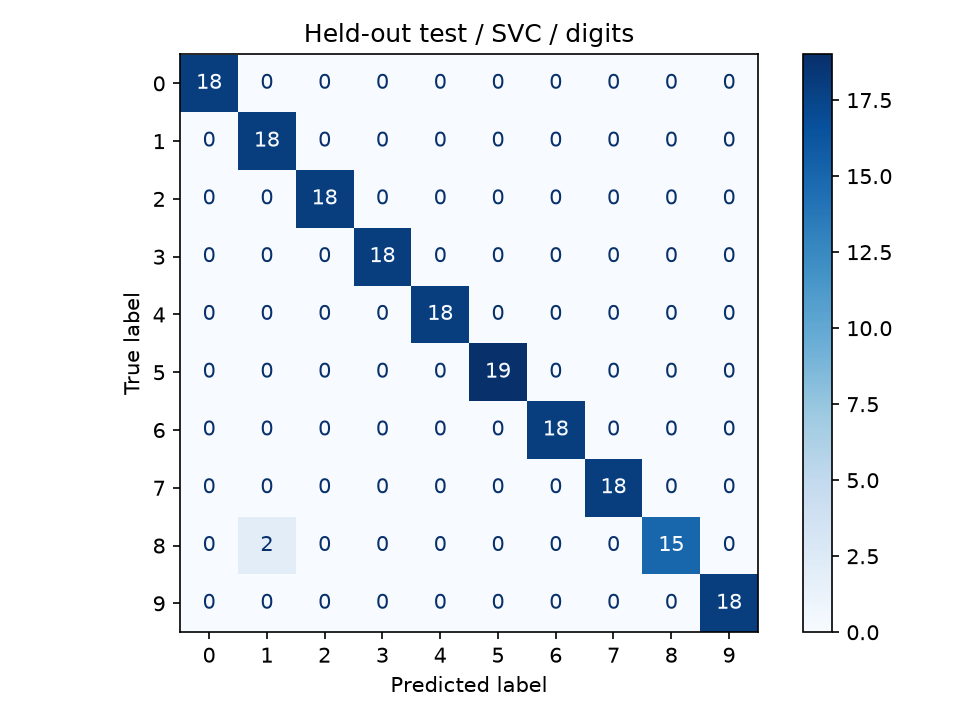
테스트 혼동행렬 원본
혼동행렬에서는 숫자 8을 1로 분류한 두 사례를 확인할 수 있다. 예측 이미지에는 오분류를 먼저 배치하고 제목을 빨간색으로 표시했다.
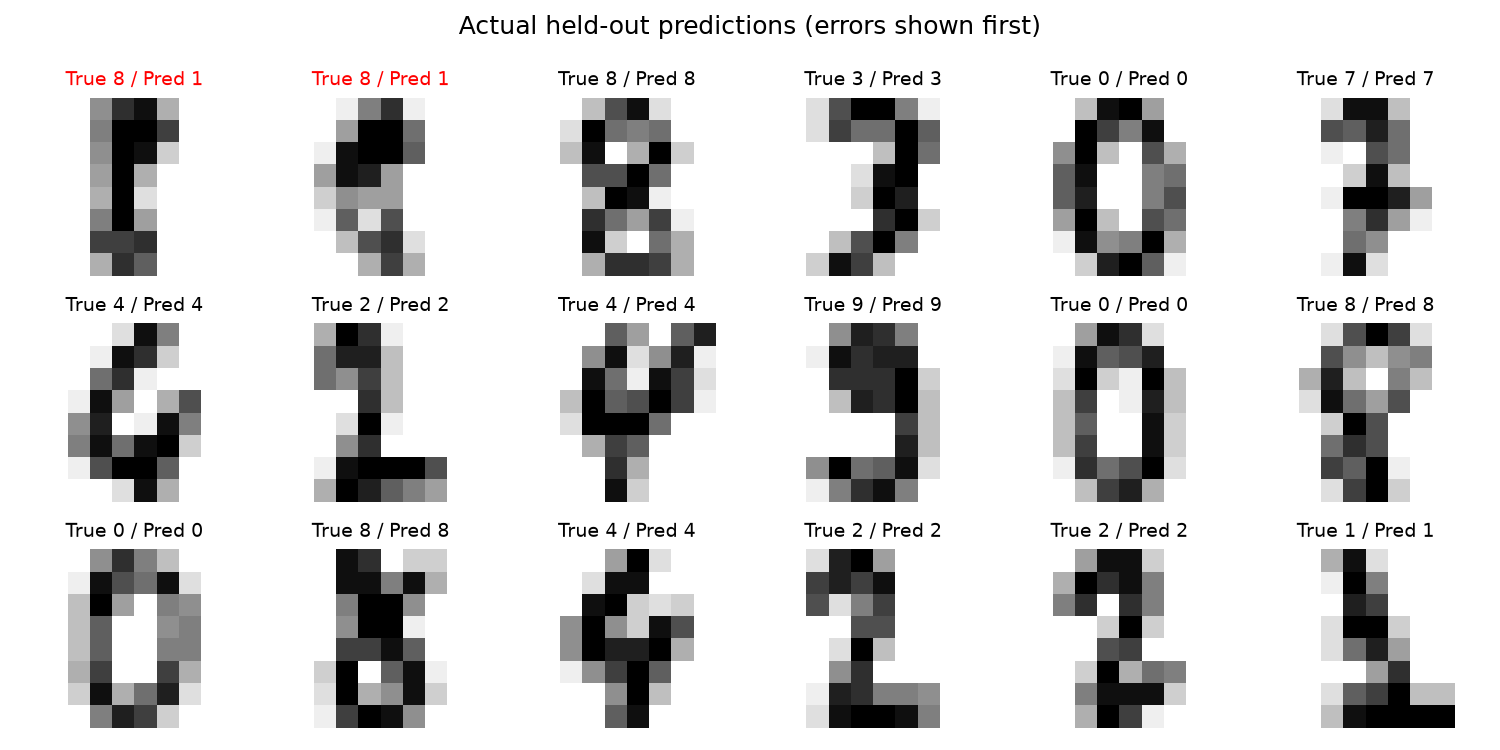
테스트 예측 원본
7. 공유 경로와 명시적인 실행 순서
@dsl.pipeline(name="digits-shared-directory-pipeline")
def shared_pipeline(root: str = "/workspace/results/shared", seed: int = 42):
    prepared = prepare_shared(root=root, seed=seed)
    fitted = fit_shared(root=root).after(prepared)
    evaluate_shared(root=root).after(fitted)
이 방식의 준비와 학습 단계는 Dataset/Model을 출력 아티팩트로 넘기지 않는다. 모두 root/dataset과 root/model.pkl이라는 공통 경로를 사용한다. 평가 지표와 보고서는 여전히 KFP 출력 아티팩트로 남긴다.
같은 문자열을 전달했다는 사실만으로 KFP에 데이터 의존성이 생기지 않는다. 따라서 .after(prepared), .after(fitted)를 사용해 선행 단계를 표현했다. 로컬 실행 순서에 우연히 기대지 않고, 컴파일한 정의에도 순서가 포함되도록 만든 것이다.
실제 Kubernetes PVC를 사용할 때는 공통 볼륨을 각 Pod에 마운트하는 별도 작업이 필요하다. 여기서는 단일 Docker bind mount가 그 역할의 일부를 대체한다. 클러스터 스토리지 접근 모드, 여러 노드에서의 마운트, 오브젝트 스토리지 전송은 확인하지 않았다.
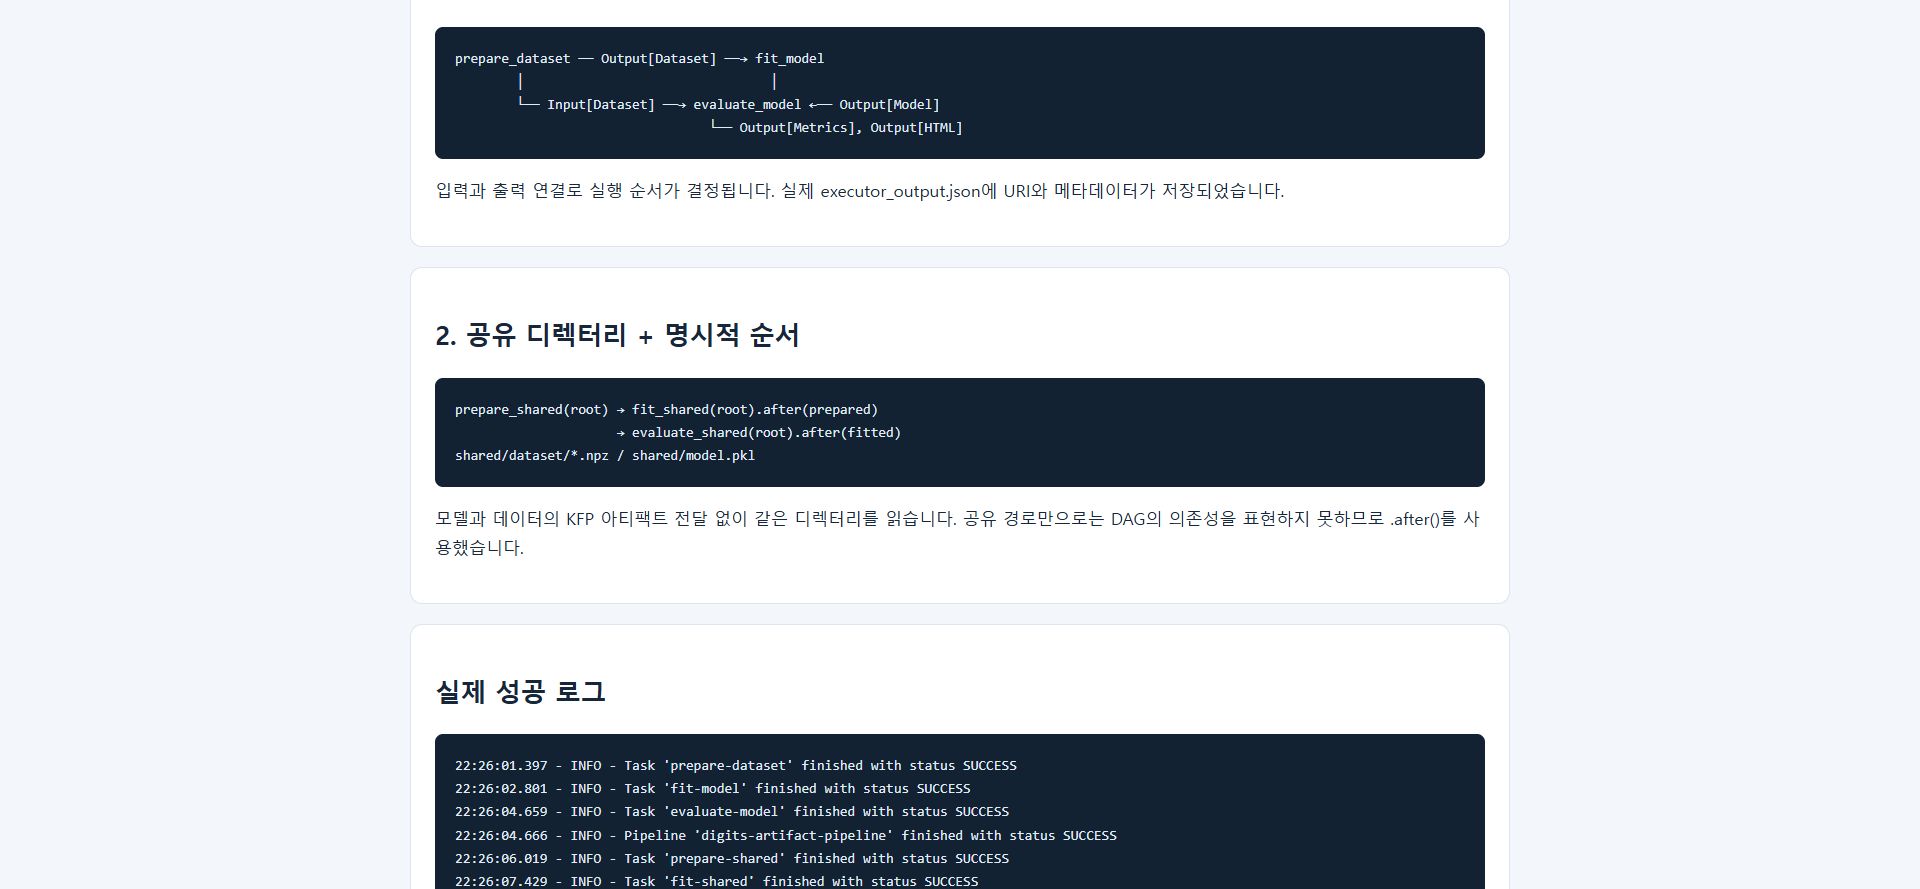
두 파이프라인의 성공 로그
8. 결과가 일치하는지 확인하기
두 방식 모두 같은 seed와 학습 함수를 사용했다. 실제 모델 SHA-256은 다음과 같다.
a3a9ea46253da3ff0b11c22666cb1ffe76d2513c7788421570aaf70f3a95fa7b
실행 스크립트는 두 평가의 존재, 모델 해시 일치, 정확도 일치, 정확도 90% 초과, 기준 모델보다 높은 정확도를 확인한다. 데이터 분리의 ID 교집합 확인은 준비 단계에서 수행한다.
CHECKS PASSED
both_runs_completed: true
identical_model_hash: true
identical_test_accuracy: true
test_accuracy_above_90_percent: true
실제 메타데이터와 전체 로그는 함께 보관했다. 화면 캡처는 실행 결과 파일을 읽어 만든 로컬 HTML 리포트의 Chrome 캡처이며 Kubeflow 서버 화면은 아니다.
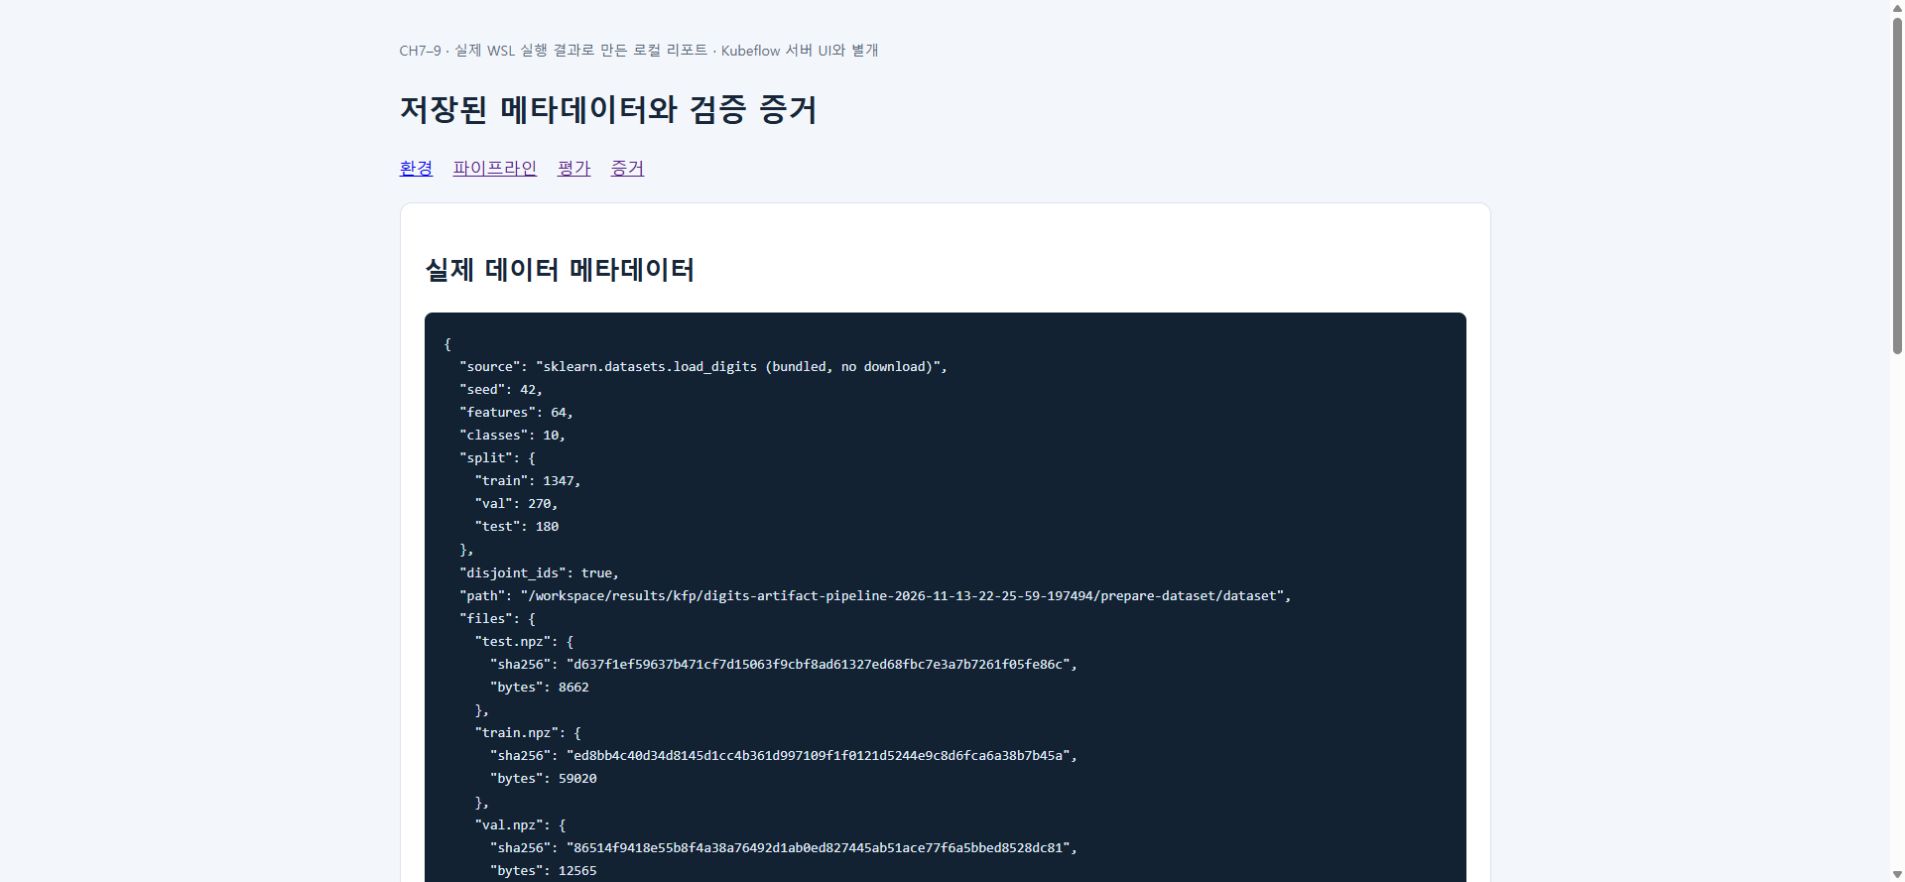
실제 메타데이터
9. 요약
이번 실습을 통해 데이터 준비·학습·평가를 독립적인 컴포넌트로 나누고, KFP 아티팩트와 메타데이터로 단계별 결과를 연결하는 방법을 익혔다. 공유 경로를 사용할 때는 .after()로 실행 순서를 명확히 하고, 검증 데이터로 모델을 선택한 뒤 테스트 데이터로 최종 성능을 평가해야 한다는 점도 확인했다. 또한 같은 seed와 모델 해시로 재현성을 점검하며, GPU나 Kubernetes 없이도 작은 로컬 환경에서 MLOps 파이프라인의 핵심 구조를 실습할 수 있었다.
'MLOps & LLMOps' 카테고리의 다른 글
| [MLOps 플랫폼 스터디] BentoML API부터 데이터 드리프트까지, WSL 환경에서 실습 (0) | 2026.11.14 |
|---|---|
| [MLOps 플랫폼 스터디] 실습: WSL에서 MLflow, Feast, Kubeflow Pipelines 연결 (0) | 2026.10.31 |
| [MLOps 플랫폼 스터디] AWS MLOps 성숙도와 쿠버네티스 역할 (feat. Amazon EKS) (0) | 2026.10.25 |