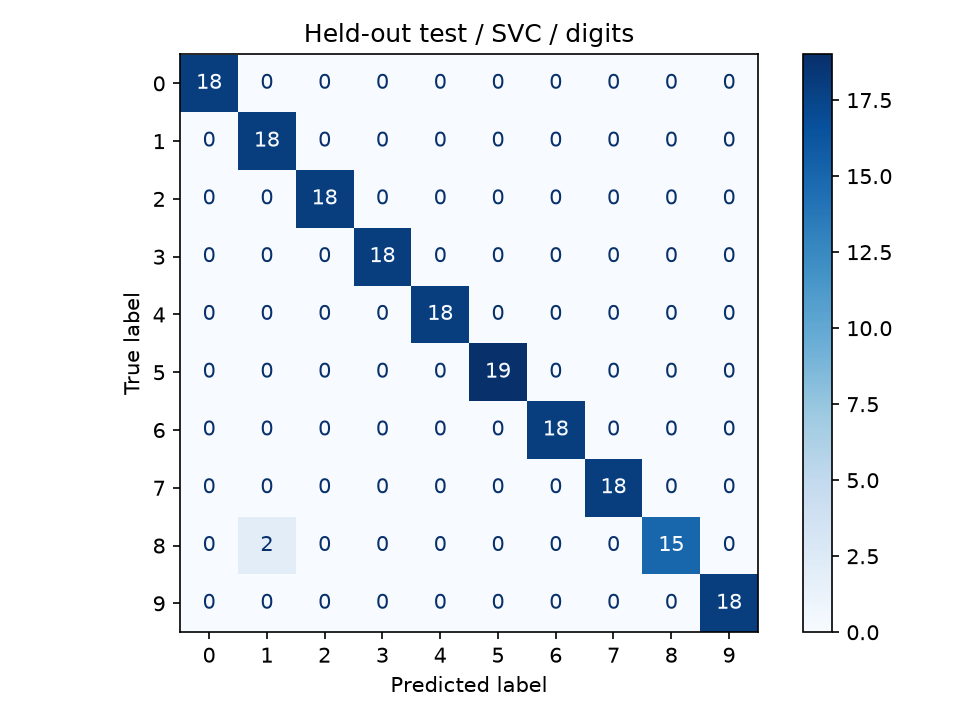
책에 언급된 MLOps Flow에 대한 실습을 로컬 WSL 환경에서 CPU 기반의 실습으로 커스터마이징하여 진행하였다. KFP SDK로 실제 파이프라인을 실행하고 데이터셋, 모델, 지표, HTML 리포트를 파일로 남겼다. 두 파이프라인 모두 성공했고 테스트 정확도는 98.89%였다.
1. 실습 범위 설정
책에 언급된 주제
실습 범위
CH7 Input/Output 아티팩트와 메타데이터
Dataset → Model → Metrics/HTML 연결을 KFP 로컬 실행으로 확인
CH8 데이터 준비, 훈련, 검증, 결과 시각화
digits 준비 → SVC 학습 → 검증으로 C 선택 → 테스트 평가
CH9 공유 PVC와 .after() 의존성
Docker bind mount의 공유 경로와 .after()로 순서 제어
YOLO 객체 탐지와 큰 이미지 데이터
8×8 숫자 이미지 분류로 대체
Kubernetes PVC·오브젝트 스토리지·서버 UI
(생략)
책 7–9장에 설명된 아티팩트 전달, 학습·검증, 공유 저장소 개념을 로컬 실습을 진행해 보았다. 실제 PersistentVolumeClaim을 만들거나 스케줄링·접근 모드를까지는 진행하지 않았으며, KFP 로컬 모드에서는 아티팩트도 로컬 파일이므로 네트워크 업로드와 다운로드 속도를 하지 않았다.
2. 실습 환경
이번 컴퓨터에는 WSL Ubuntu, Docker에서 book-env/runtime:0.1 이미지를 기반으로 사용하였다.
WSL 경로를 $PWD로 전달하고 Docker에서는 /workspace로 읽는다. --rm으로 실행 컨테이너는 종료 후 제거되지만 bind mount에 저장한 결과는 로컬에 남는다. 원래 실행 중이던 다른 컨테이너는 건드리지 않는다.
파일 역할은 다음과 같다.
run_lab.py: 타입이 있는 KFP 컴포넌트, 두 파이프라인, 컴파일, 실행, 결과 비교.
lab_steps.py: 데이터 준비, 모델 학습, 평가 구현.
compiled/*.yaml: KFP가 생성한 실제 파이프라인 정의.
results/kfp/: 실행별 아티팩트와 executor_output.json.
results/shared/: 공유 방식에서 사용하는 데이터와 모델.
logs/run.log, evidence/summary.json: 원본 로그와 최종 확인 결과.
이미지 ID는 evidence/environment.txt에 기록했다. 환경 재구성 예시는 ../Dockerfile.rebuild이며, 패키지 설치를 위한 인터넷은 그때만 필요하다. 실제 실행에서는 재빌드하지 않았다.
4. 데이터 준비: 분리된 train / validation / test
load_digits()의 1,797개 샘플을 사용한다. 각 이미지의 64개 픽셀 값을 16으로 나눠 0–1 범위로 만들고, 정답 클래스 비율을 유지하는 stratify와 random_state=42를 적용했다.
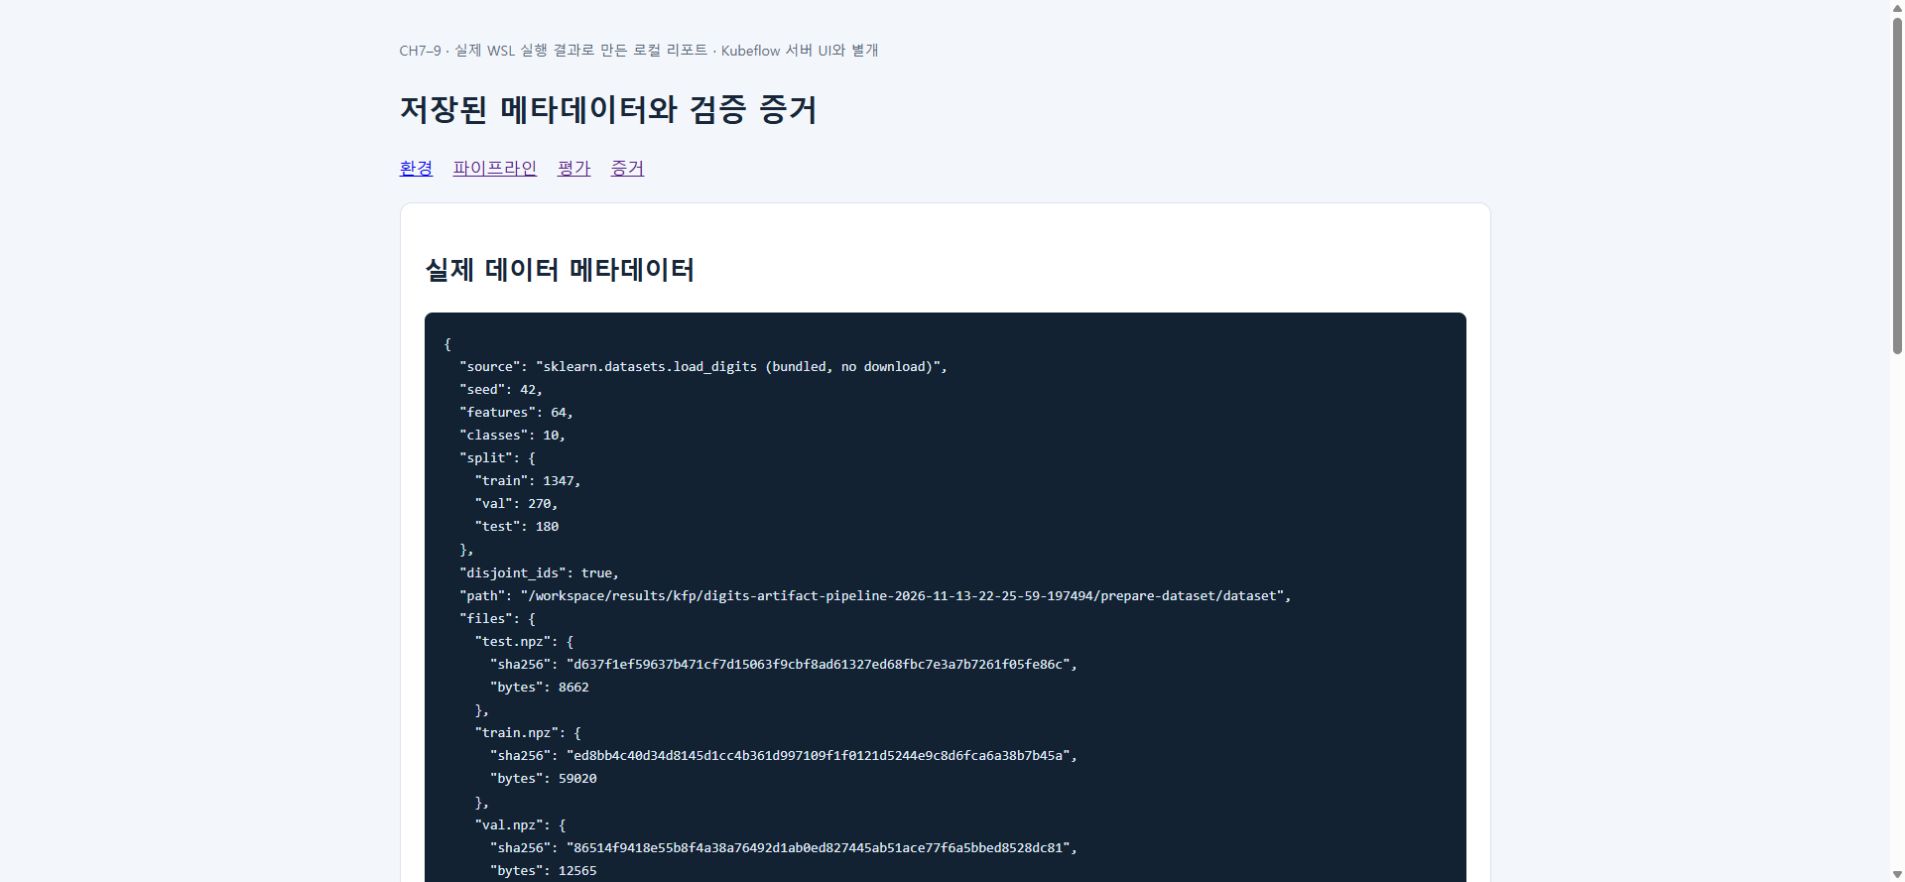
먼저 75%를 train으로 떼고, 나머지 25%에서 60%를 validation, 40%를 test로 나눈다. 반올림 때문에 실제 개수는 train 1,347, validation 270, test 180이다. 각 샘플의 원래 ID를 저장해 세 집합의 교집합이 없고 전체 ID를 빠짐없이 포함하는지 assertion으로 확인했다.
train.npz, val.npz, test.npz에는 X, y, ids가 들어간다. 파일 합계는 80,247바이트다. 메타데이터에는 split, seed, 파일 크기, SHA-256을 저장했다. 픽셀 범위의 고정 상수 16으로 정규화했으므로 validation이나 test의 통계로 전처리 값을 학습하지 않는다.
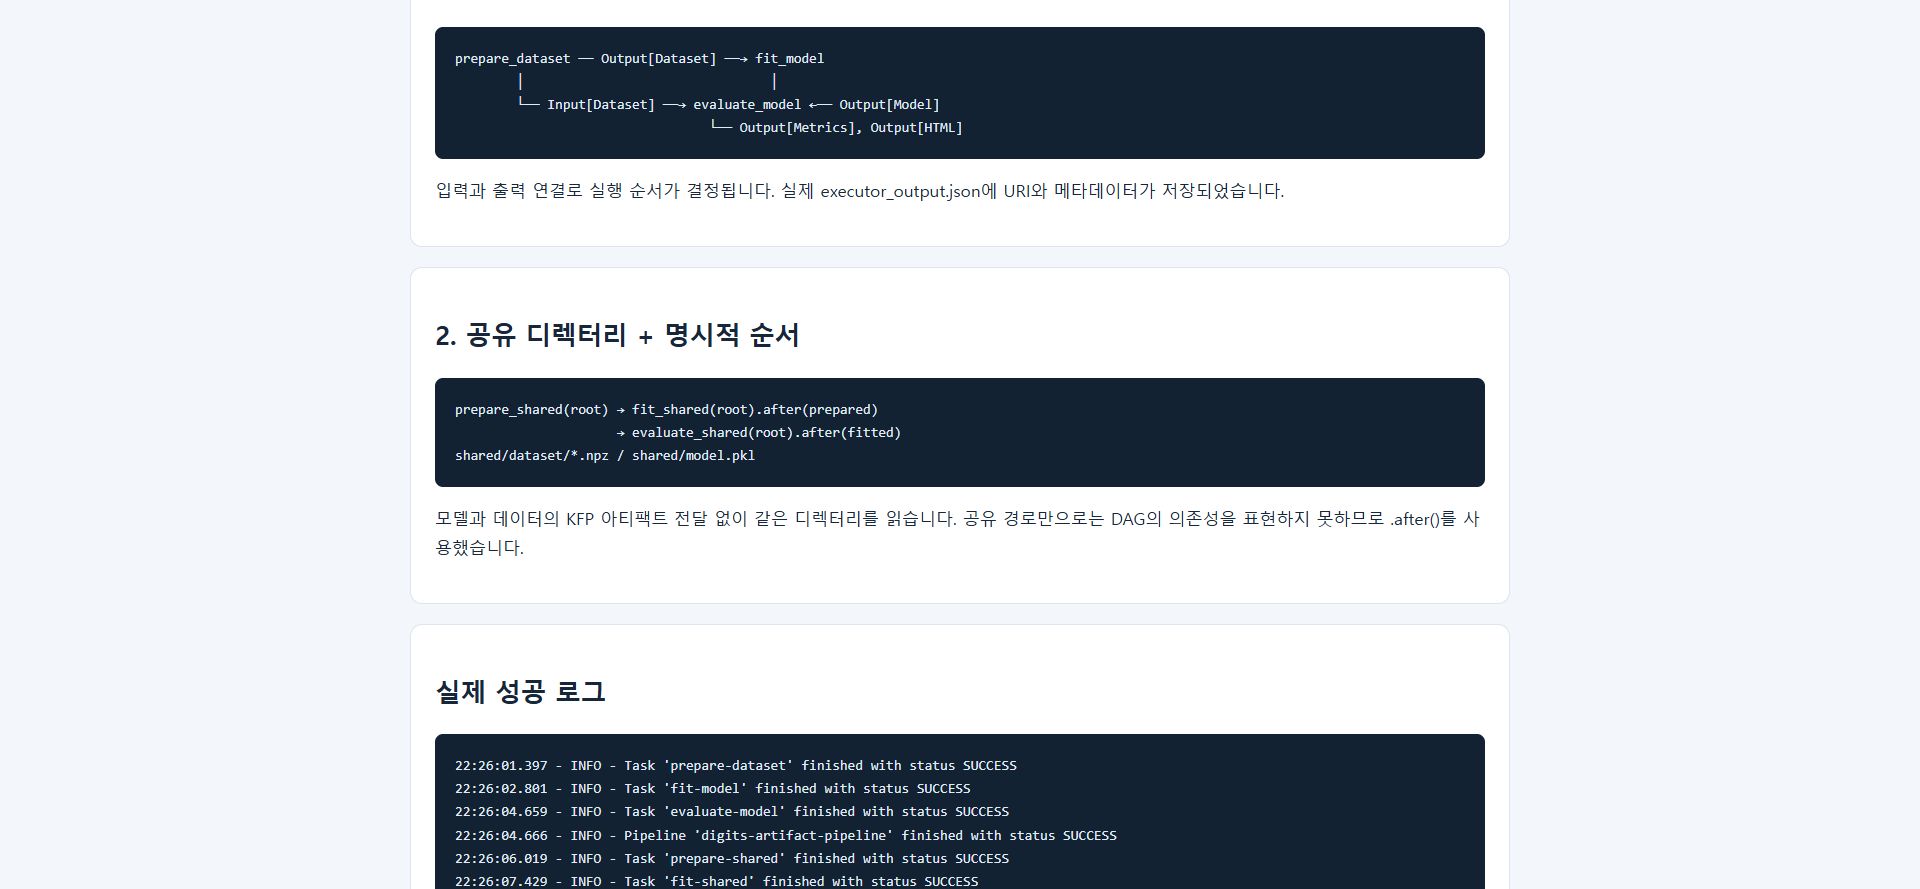
데이터 준비 컴포넌트는 Output[Dataset]의 .path에 데이터를 쓴다. 학습 컴포넌트는 Input[Dataset]의 .path를 읽고 Output[Model]에 모델을 쓴다. 평가에서는 두 입력 아티팩트가 제공하는 경로를 읽는다. 이전 단계의 실제 경로를 임의의 문자열로 하드코딩하지 않는다.
파일 내용과 메타데이터는 구분해야 한다. .path 아래에는 실제 파일을 저장하고, .metadata에는 데이터 출처·해시 등을 기록한다. metrics.log_metric()으로 기록한 값은 Metrics 아티팩트의 메타데이터에 들어간다. HTML 보고서와 PNG 파일도 실제로 생성했다.
컴파일한 YAML은 정의를 확인하는 자료다. 컴포넌트가 lab_steps 모듈을 import하므로 이 YAML을 클러스터에 올릴 때는 해당 모듈을 포함한 이미지가 추가로 필요하다. 현재 코드는 로컬 /workspace 마운트와 PYTHONPATH를 사용한다.
6. 학습과 평가의 역할 분리
학습에서는 RBF SVC의 C 값을 0.1, 1.0, 10.0으로 바꿔 각각 train 데이터에 fit하고 validation 정확도로 선택했다.
C
Validation accuracy
0.1
94.81%
1.0
99.26%
10.0
99.26%
최고 점수가 같아 먼저 평가한 C=1.0을 선택했다. 선택 후 train+validation으로 재학습하지 않고 선택한 train 학습 모델을 그대로 테스트했다. DummyClassifier(strategy="most_frequent")도 같은 train 데이터로 학습해 기준 성능을 만들었다.
테스트 결과
값
SVC 정확도
98.89%
기준 모델 정확도
10.00%
정답 / 전체
178 / 180
오분류
2개
Weighted F1
0.988834
테스트 데이터는 C를 선택하는 데 쓰지 않았다. 이 한 번의 고정 split에 대한 결과이며, 교차 검증이나 외부 데이터 일반화 성능을 검증한 결과는 아니다.
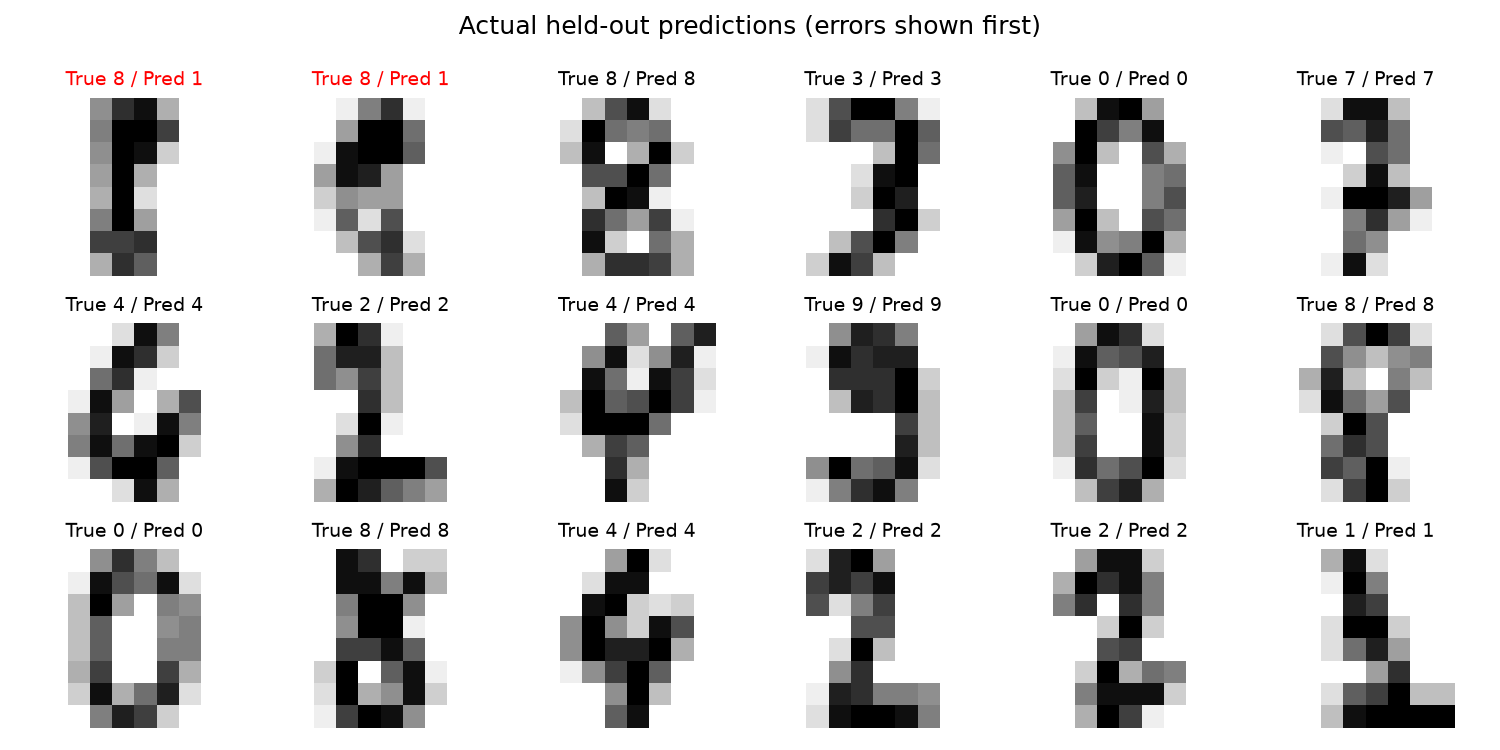
테스트 혼동행렬 원본
혼동행렬에서는 숫자 8을 1로 분류한 두 사례를 확인할 수 있다. 예측 이미지에는 오분류를 먼저 배치하고 제목을 빨간색으로 표시했다.
이 방식의 준비와 학습 단계는 Dataset/Model을 출력 아티팩트로 넘기지 않는다. 모두 root/dataset과 root/model.pkl이라는 공통 경로를 사용한다. 평가 지표와 보고서는 여전히 KFP 출력 아티팩트로 남긴다.
같은 문자열을 전달했다는 사실만으로 KFP에 데이터 의존성이 생기지 않는다. 따라서 .after(prepared), .after(fitted)를 사용해 선행 단계를 표현했다. 로컬 실행 순서에 우연히 기대지 않고, 컴파일한 정의에도 순서가 포함되도록 만든 것이다.
실제 Kubernetes PVC를 사용할 때는 공통 볼륨을 각 Pod에 마운트하는 별도 작업이 필요하다. 여기서는 단일 Docker bind mount가 그 역할의 일부를 대체한다. 클러스터 스토리지 접근 모드, 여러 노드에서의 마운트, 오브젝트 스토리지 전송은 확인하지 않았다.
두 파이프라인의 성공 로그
8. 결과가 일치하는지 확인하기
두 방식 모두 같은 seed와 학습 함수를 사용했다. 실제 모델 SHA-256은 다음과 같다.
실제 메타데이터와 전체 로그는 함께 보관했다. 화면 캡처는 실행 결과 파일을 읽어 만든 로컬 HTML 리포트의 Chrome 캡처이며 Kubeflow 서버 화면은 아니다.
실제 메타데이터
9. 요약
이번 실습을 통해 데이터 준비·학습·평가를 독립적인 컴포넌트로 나누고, KFP 아티팩트와 메타데이터로 단계별 결과를 연결하는 방법을 익혔다. 공유 경로를 사용할 때는 .after()로 실행 순서를 명확히 하고, 검증 데이터로 모델을 선택한 뒤 테스트 데이터로 최종 성능을 평가해야 한다는 점도 확인했다. 또한 같은 seed와 모델 해시로 재현성을 점검하며, GPU나 Kubernetes 없이도 작은 로컬 환경에서 MLOps 파이프라인의 핵심 구조를 실습할 수 있었다.
모델을 학습하고 정확도를 확인하는 일과, 다른 프로그램이 그 모델을 사용할 수 있도록 만드는 일 사이에는 여러 연결이 필요하다. 모델 파일을 저장하고, 예측 요청을 받아들이고, 학습 때와 같은 입력 형식을 지키며, 새로운 데이터의 변화를 확인해야 한다.
6–7장을 공부하면서 이 연결을 직접 확인해 보고 싶었다. Windows의 WSL2 환경에서 작은 Iris 분류 모델을 학습하고, BentoML로 HTTP API를 만든 뒤, Evidently로 데이터 드리프트 보고서를 생성하는 실습을 구성했다.
이번 블로그 포스트에서는 책 내용을 옮기기보다, 이 미니 실험을 통해 무엇을 확인했고 그 결과를 어떻게 해석했는지에 초점을 맞추었다. 책에 언급된 데이터셋을 기반으로 실습을 진행해보았다.
1. 실습 범위와 환경
실행 흐름은 단순하다.
Iris 데이터 → 모델 학습 → 모델 파일 저장 → HTTP 예측 API
                  ↓
            기준·비교 CSV 저장 → 별도 프로세스 → 드리프트 보고서
항목
실제 실행 환경
호스트
Windows + Ubuntu WSL2
실행 방식
WSL에서 Docker 컨테이너 실행
컨테이너 제한
CPU 2개, 메모리 2GiB
Python
3.12.16
BentoML
1.4.40
Evidently
0.7.23
scikit-learn
1.9.1
pandas
2.3.3
데이터·모델
내장 Iris 데이터, 표준화 + 로지스틱 회귀
GPU는 사용하지 않았다. Kubernetes나 Kubeflow 클러스터 배포는 이번 실행 범위에 포함하지 않았다. 7장의 내용 중 입력·출력 계약과 데이터 전달을 로컬 파일 예제로 연결했고, Kubeflow Notebooks와 Pipelines의 클러스터 동작은 개념 학습으로 구분했다.
이렇게 범위를 정하면 작은 환경에서도 모델 파일, API, 데이터, 보고서가 연결되는 과정을 끝까지 확인할 수 있다.
2. 학습 결과를 파일로 남기기
Iris 데이터 150개를 학습 105개와 테스트 45개로 나눴다. 클래스 비율을 유지하도록 분할하고, 분할 시드는 42로 고정했다. 전처리와 분류기를 하나의 scikit-learn Pipeline으로 묶어 저장했다.
이번 실행에서 보류한 테스트 데이터의 정확도는 약 91.11%, 45개 중 41개 정답이었다. 작은 데이터셋의 특정 분할에서 얻은 값이므로 실제 서비스 성능을 대표하는 숫자로 해석하지 않았다.
모델과 함께 다음 정보도 기록했다.
입력 피처의 이름과 순서
클래스 이름
학습·테스트 표본 수와 분할 시드
테스트 정확도
저장된 모델 파일의 SHA-256 해시
실제 Python 및 패키지 버전
학습 단계만 따로 실행하려면 이미지 빌드(7절) 후 실습 폴더에서 다음 명령을 쓴다.
docker run --rm \
  --mount "type=bind,source=$PWD,target=/workspace" \
  mlops-mini:ch6-ch7 python prepare.py
실행하면 학습 정보가 출력되고, 같은 내용이 artifacts/training.json에 저장된다. 아래는 이번 실행에서 기록된 내용이다. 배열만 한 줄로 줄였다.
읽는 순서는 이렇다. train_rows와 test_rows의 합이 150인지 확인하고, test_accuracy가 본문의 41/45와 같은 값인지 본다. features의 순서는 3절의 API 입력 순서와 같아야 하고, model_sha256은 3절의 API 응답에 다시 등장한다.
해시는 이후 API가 같은 모델 파일을 사용했는지 확인하는 데 활용했다. 모델 파일의 해시만으로 코드와 데이터까지 재현되는 것은 아니므로, 패키지 목록과 데이터 생성 코드도 함께 보관했다.
학습에서 중요한 것은 좋은 점수 하나를 남기는 것뿐 아니라, 그 점수가 어떤 모델과 환경에서 나왔는지 다시 찾을 수 있도록 만드는 일이었다.
상태 코드는 400이 나와야 한다. 서버 쪽 로그(artifacts/server.log)에는 두 요청이 이렇게 남았다. 추적 ID 등 뒷부분은 생략했다.
[INFO]  ... (method=POST,path=/predict,type=application/json,length=76) (status=200,type=application/json,length=162) 22.638ms
[ERROR] ... Exception on /predict [POST]
bentoml.exceptions.InvalidArgument: Each row needs four finite numbers in the documented feature order
[INFO]  ... (method=POST,path=/predict,type=application/json,length=22) (status=400,type=application/json,length=80) 6.310ms
로그에 [ERROR]와 Traceback이 보여도 서버가 죽은 것은 아니다. 서비스 코드가 입력 형태를 검사해 의도적으로 InvalidArgument를 던졌고, BentoML이 이를 HTTP 400으로 바꿔 돌려준 기록이다. 이 검사가 없으면 잘못된 형태의 요청은 모델 내부 오류로 이어져 호출자가 원인을 알기 어렵다.
세 입력에 대한 응답은 각각 setosa, versicolor, virginica였다. 이번 검증에서는 다음을 확인했다.
검증
실행 결과
정상 입력으로 /predict 호출
HTTP 200
API 예측과 저장된 모델의 직접 예측 비교
일치
응답의 모델 해시와 학습 산출물 비교
일치
피처가 두 개뿐인 잘못된 입력
HTTP 400
이 결과가 의미하는 것은 해당 요청들이 서비스의 입력 변환과 모델 호출을 통과했다는 것이다. 부하 테스트나 운영 환경의 지연 시간, 장애 복구까지 검증한 결과는 아니다.
모델을 API로 만든 뒤에는 “분류기가 동작하는가” 외에도 “잘못된 요청을 구분하는가”, “어떤 모델이 응답했는가”, “직접 실행한 결과와 같은가”라는 질문을 다루게 됐다.
4. Evidently로 데이터 분포의 변화를 확인하기
드리프트 실험에서는 기준 데이터와 비교 데이터를 명확하게 나눴다.
기준 데이터는 학습 입력 105개다. 정상 대조군은 그와 같은 행들을 순서만 섞어 만들었다. 따라서 대조군은 새로 수집한 운영 데이터가 아니라, 분포가 동일한 경우를 확인하기 위한 통제 실험이다.
변형 데이터는 대조군에서 다음 세 피처에 일정한 값을 더해 만들었다.
피처
인위적으로 더한 값
sepal_width
+3.0
petal_length
+4.0
petal_width
+2.0
sepal_length는 그대로 뒀다. 이 값들은 현실의 꽃이나 운영 환경을 모사하려고 정한 것이 아니다. 탐지 동작을 관찰하기 위해 의도적으로 크게 바꾼 합성 데이터다.
이번 보고서에 기록된 피처별 방법은 K-S 검정의 p-value, 임계값은 0.05였다. 실제 결과는 다음과 같다.
비교 데이터
기준·비교 표본 수
드리프트로 탐지된 피처
피처 비율
같은 행을 섞은 대조군
각각 105개
0 / 4
0%
세 피처에 오프셋을 더한 데이터
각각 105개
3 / 4
75%
변경하지 않은 피처는 탐지되지 않았고, 인위적으로 바꾼 세 피처는 탐지됐다. HTML 보고서와 JSON 지표를 모두 저장해 화면에서 살펴보거나 코드로 결과를 확인할 수 있게 했다.
보고서 화면 읽기
보고서는 7절의 전체 실행으로 만들어지며, 이 단계만 다시 돌리려면 다음 명령을 쓴다. 생성된 HTML은 Windows 탐색기에서 artifacts 폴더를 열어 브라우저로 볼 수 있다.
docker run --rm \
  --mount "type=bind,source=$PWD,target=/workspace" \
  mlops-mini:ch6-ch7 python drift.py
Saved drift_normal.html and drift_normal.json
Saved drift_shifted.html and drift_shifted.json
아래 화면은 이번 실행에서 저장된 HTML 보고서를 브라우저로 연 모습이다.
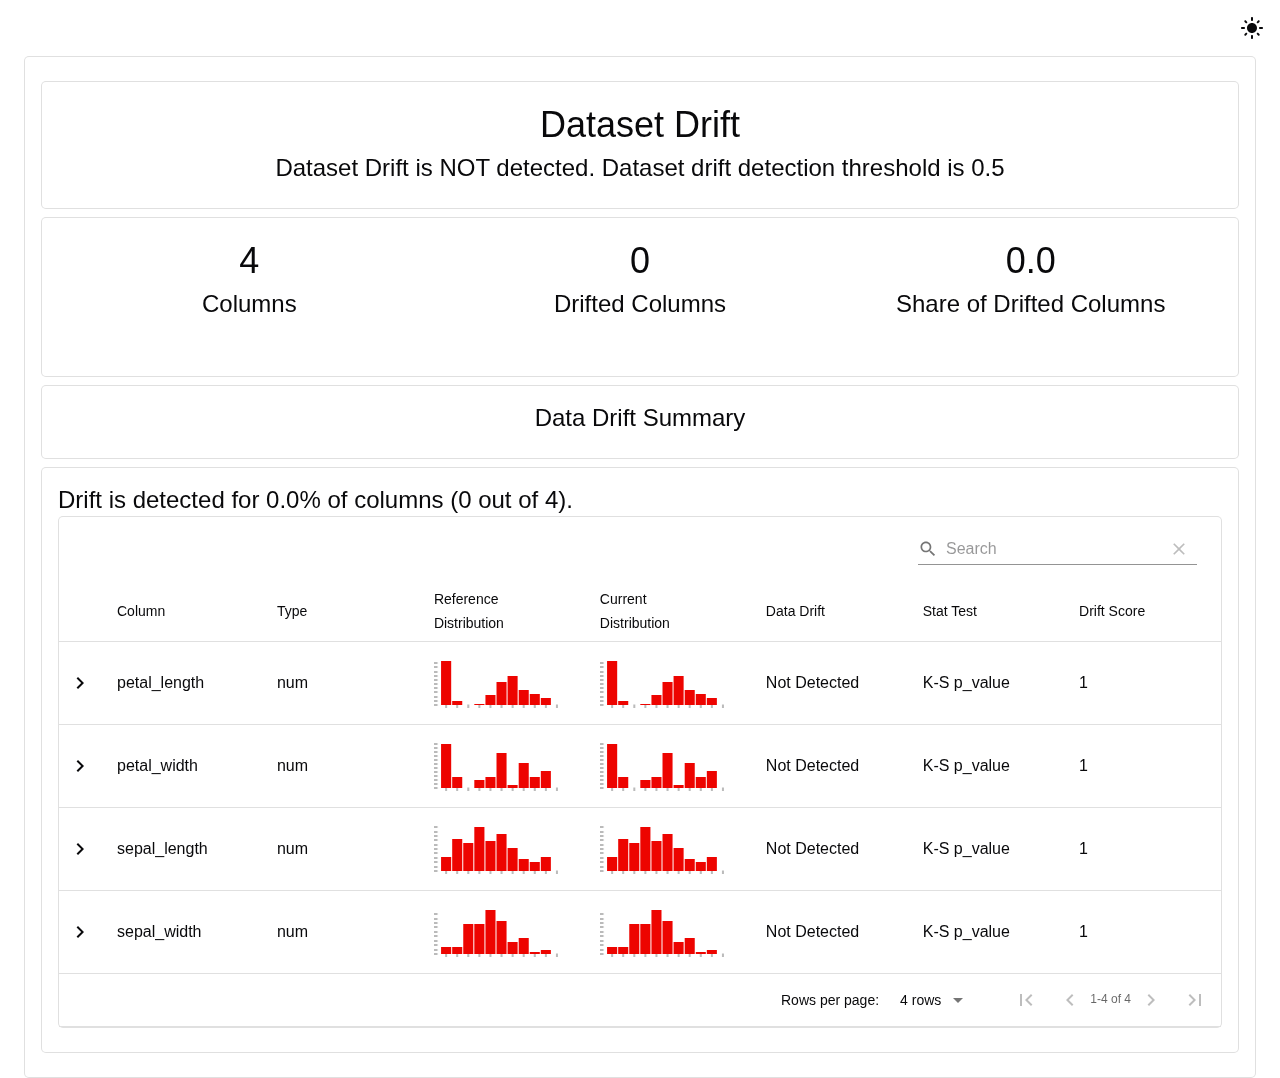
먼저 대조군이다.
대조군 보고서: 4개 열 중 드리프트 0개
위에서부터 다음 세 가지를 중심으로 살펴보자.
"Dataset Drift is NOT detected. Dataset drift detection threshold is 0.5": 데이터셋 전체의 판정이다. 드리프트된 열의 비율을 임계값 0.5와 비교해 데이터셋 드리프트 여부를 정한다. 여기서는 0 / 4이므로 탐지되지 않았다.
"4 columns, 0 drifted columns, and 0.0 share of drifted columns": 가운데 숫자 세 개는 전체 열 수, 드리프트된 열 수, 그 비율이다.
아래 표는 열마다의 결과다. Stat Test가 사용한 검정, Drift Score가 그 검정의 p-value다. 네 열 모두 p-value가 1이다. 같은 행을 순서만 섞었으니 두 분포가 완전히 같고, 그래서 가능한 가장 큰 값이 나왔다.
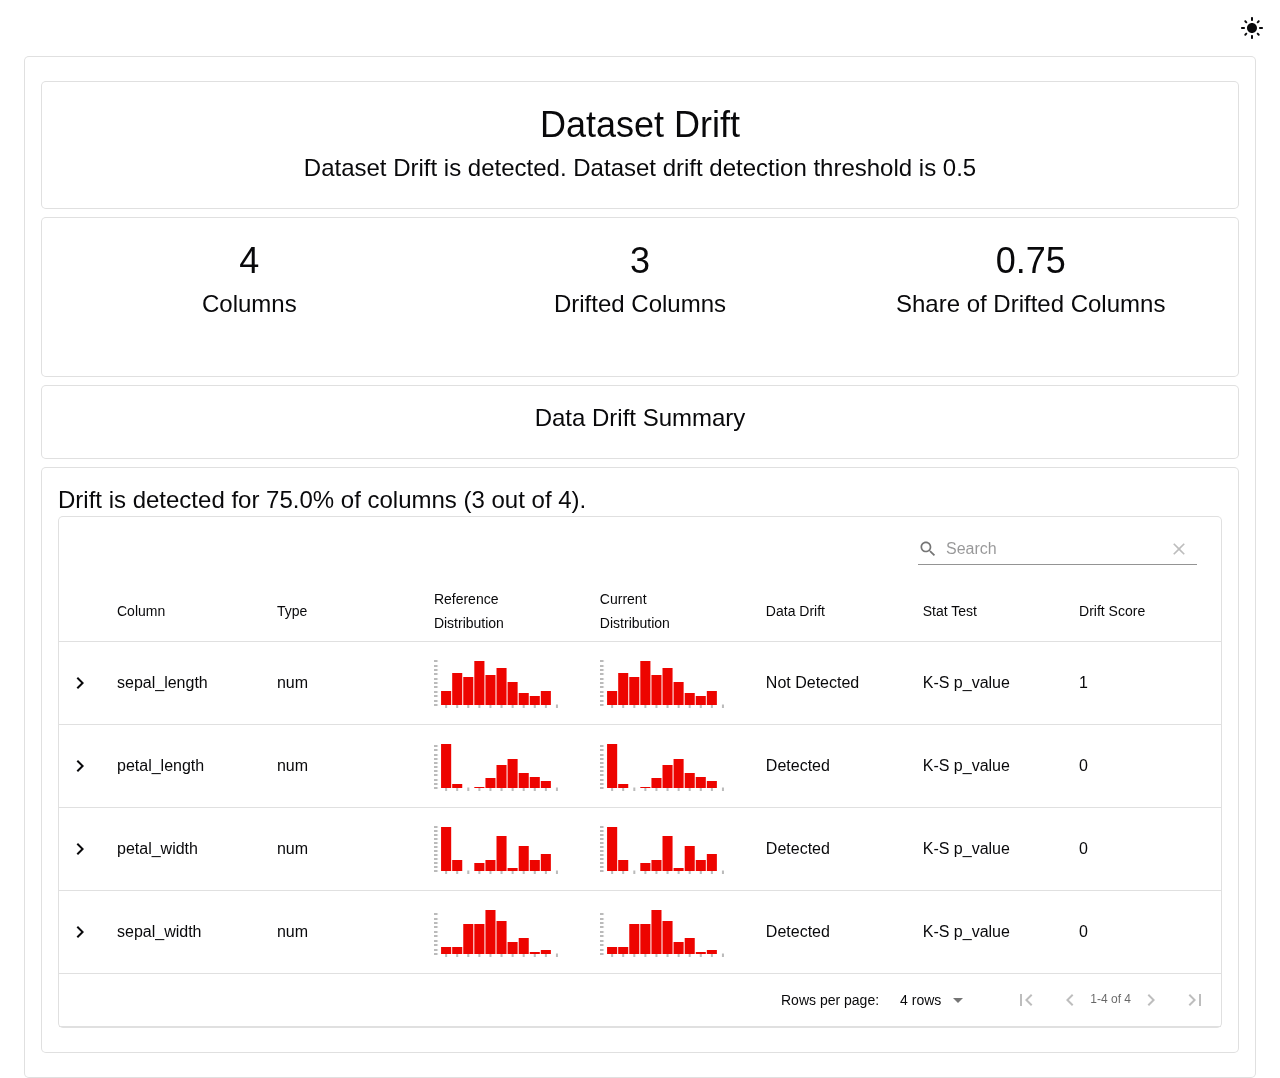
다음은 변형 데이터다.
변형 데이터 보고서: 4개 열 중 3개 드리프트
열 3개가 Detected로 바뀌었고 비율은 0.75로 임계값 0.5를 넘어 데이터셋 드리프트로 판정됐다. sepal_length만 p-value 1로 남았다. 손대지 않은 열이 그대로라는 점이 탐지 결과를 믿을 근거가 된다.
화면에 Drift Score가 0으로 보이는 것은 반올림된 표시다. JSON에 기록된 실제 p-value는 다음과 같다.
피처
p-value
판정 (임계값 0.05)
sepal_length
1.0
탐지 안 됨
sepal_width
약 2.2e-62
탐지
petal_length
약 4.9e-31
탐지
petal_width
약 9.6e-38
탐지
p-value는 두 표본이 같은 분포에서 나왔다는 가정 아래, 관찰한 검정 통계량 이상으로 극단적인 차이가 나올 확률이다. 작은 값은 그 가정에 반하는 증거가 된다. 분포가 같을 확률이나 변화의 크기를 직접 뜻하는 값은 아니다. sepal_width가 가장 작은 이유는 데이터에서 확인된다. 기준 데이터의 범위는 2.0–4.4인데 변형 데이터는 5.0–7.4로, 두 범위가 전혀 겹치지 않는다.
한 가지 주의할 점이 있다. 표 안의 작은 히스토그램은 기준과 비교 데이터가 거의 같은 모양으로 보인다. 일정한 값을 더하면 분포의 모양은 그대로이고 위치만 옮겨지는데, 작은 그림은 각자의 값 범위에 맞춰 그려진 것으로 보인다. 그래서 썸네일만 보고 “변화가 없다”고 읽으면 안 되고, 행을 펼쳐 같은 축에서 비교해야 한다.
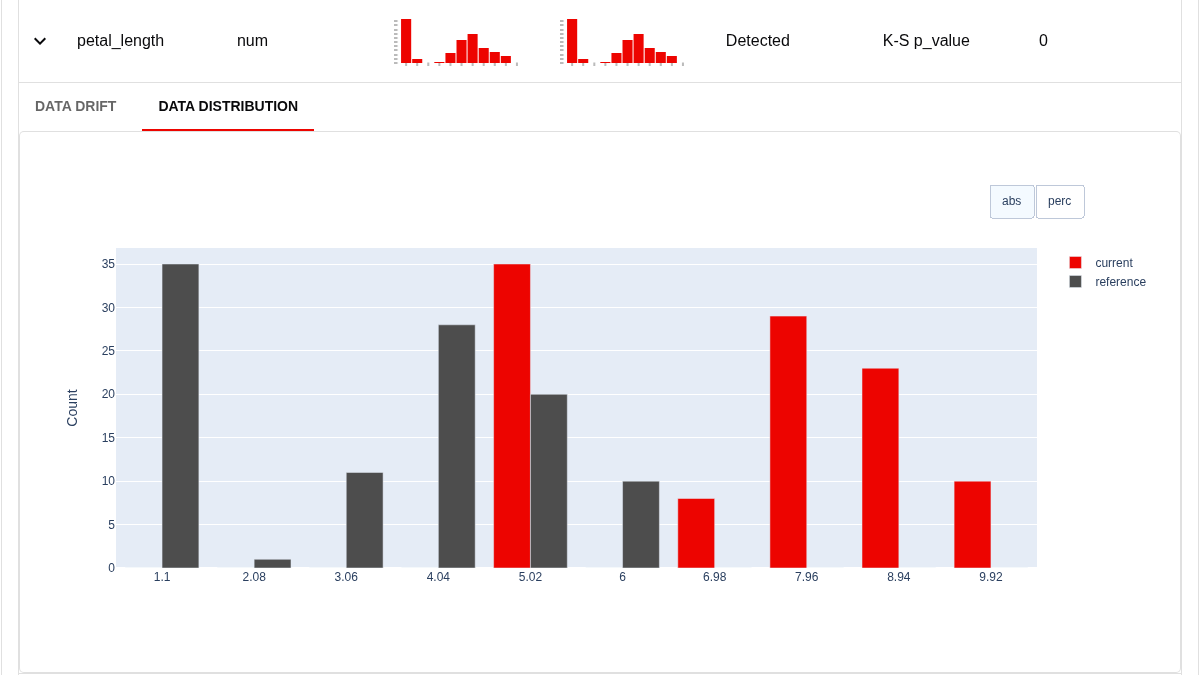
petal_length 행 왼쪽의 화살표를 눌러 펼친 뒤 DATA DISTRIBUTION 탭을 선택한 화면이다.
petal_length의 기준·비교 분포를 같은 축에 그린 화면
회색이 기준, 빨간색이 비교 데이터다. 기준 데이터는 1.1–6.9에 있고 비교 데이터는 5.1–10.9로 오른쪽으로 4만큼 옮겨졌다. 모양은 같고 위치만 다르다는 것이 한눈에 보인다.
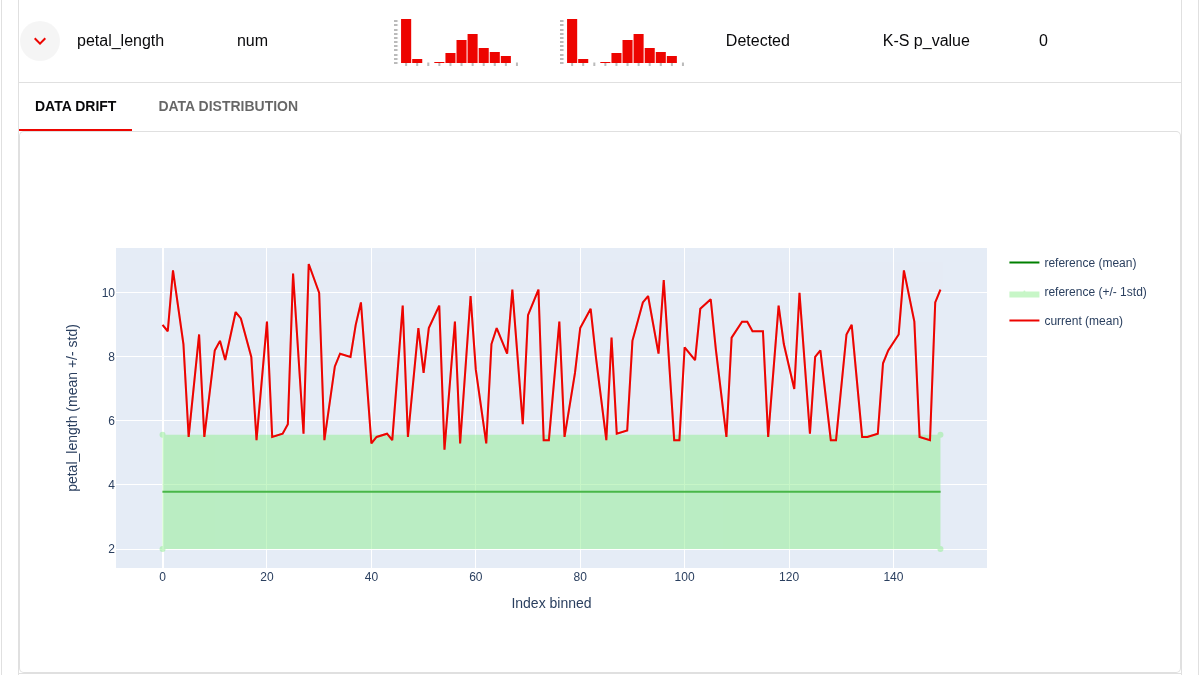
같은 행의 DATA DRIFT 탭은 다른 방식으로 같은 사실을 보여 준다.
petal_length의 기준 평균·표준편차 범위와 비교 데이터 값
초록 선은 기준 데이터의 평균(약 3.78), 초록 띠는 평균에서 표준편차 1만큼의 범위다. 빨간 선인 비교 데이터가 대부분 띠 위쪽에 있다. 운영 데이터를 시간 순으로 넣었다면 이 그림에서 값이 언제부터 벗어났는지를 찾아볼 수 있겠지만, 이번 데이터는 순서를 섞은 것이라 가로축의 순서에는 의미가 없다.
여기서 가장 중요한 구분은 데이터 드리프트와 예측 성능 저하가 같은 결과는 아니라는 점이다. 이번 실험은 입력 분포의 변화를 확인했다. 변형된 입력의 실제 정답을 수집해 서비스 정확도가 얼마나 떨어졌는지는 검증하지 않았다.
드리프트 알림이 생기면 데이터 수집 경로, 단위, 전처리, 사용자 구성의 변화 등을 조사하고, 정답을 확보할 수 있다면 성능 지표를 함께 확인하는 흐름으로 이어갈 수 있다. 재학습 여부도 그런 조사 결과를 바탕으로 판단해야 한다.
5. 별도 프로세스에 데이터를 전달하며 배운 것
데이터 생성과 보고서 생성은 서로 다른 Python 프로세스에서 실행했다. 앞 단계가 CSV를 저장하고, 뒤 단계가 그 파일을 읽는다.
작은 예제지만 다음의 계약이 필요했다.
어느 경로에 파일을 저장할 것인가
뒤 단계가 기대하는 열 이름과 타입은 무엇인가
어떤 파일이 기준 데이터이고 어떤 파일이 비교 데이터인가
데이터가 어떤 조건으로 만들어졌는가
이번 실습에서는 Docker의 bind mount로 Windows 프로젝트 폴더를 컨테이너의 /workspace에 연결했다. 컨테이너가 종료돼도 이 폴더에 저장한 결과는 Windows에서 확인할 수 있었다.
이 동작은 로컬 폴더를 공유해 확인한 결과다. Kubeflow Pipelines에서 컴포넌트 사이에 아티팩트를 전달하는 기능을 실행한 것은 아니다. 클러스터에서는 각 실행 환경이 분리되므로, 앞 단계의 로컬 경로 문자열을 넘기는 것만으로 다른 컨테이너가 같은 파일을 읽을 수 있다고 가정하면 안 된다.
7장의 학습과 연결해서 보면, 함수의 계산 내용만큼이나 입력·출력의 형식과 저장 위치를 명확히 정의하는 일이 중요하다는 점을 작은 실험에서도 느낄 수 있었다.
6. 실제로 만난 문제: 패키지 호환성
첫 실행에서 모델 학습과 API 검증은 통과했지만 Evidently를 불러오는 단계가 실패했다. 당시 설치된 조합은 Evidently 0.7.23과 pandas 3.1.1이었다.
ImportError: cannot import name 'infer_dtype_from_object'
오류는 Evidently가 불러오는 내부 모듈이 pandas의 해당 함수를 가져오는 과정에서 발생했다. pandas를 2.3.3으로 고정한 뒤에는 모델 학습, HTTP 검증, 두 개의 드리프트 보고서 생성까지 전체 실행이 통과했다.
이후 주요 도구 버전과 전체 의존성 목록을 기록하고, Docker 빌드에 검증한 전체 패키지 목록을 사용하도록 정리했다. Python 베이스 이미지도 사용한 digest로 고정했다.
이 경험은 “설치 명령이 성공했다”와 “여러 도구가 연결된 작업이 끝까지 동작했다”가 별개의 확인이라는 점을 보여 줬다. 버전 목록과 작은 전체 실행 검증을 남겨 두는 이유가 여기에 있다.
7. 직접 실행
책에 나와있는 코드를 기반으로 다음과 같이 구성하여 실습을 진행하였다. 데이터 생성, API 서비스, 보고서 생성, 전체 실행 스크립트와 Dockerfile을 준비하고, 아래 명령어를 해당 폴더에서 WSL 터미널로 실행한다. WSL에서 Docker가 동작하는 환경을 전제로 한다.
첫 번째 명령은 고정된 패키지 목록으로 이미지를 만든다. 처음에는 베이스 이미지와 패키지를 내려받느라 시간이 걸린다. 두 번째 명령은 현재 폴더를 컨테이너의 /workspace에 연결하고 run_lab.py를 실행한다.
자동 실행은 학습, 실제 HTTP 요청 검증, 보고서 생성 순서로 진행한다. 검증을 위해 띄운 API 프로세스는 작업 후 종료한다. 터미널에는 단계마다 다음 줄이 순서대로 나온다. 사이사이에 2절의 학습 정보와 3절의 요청·응답 JSON이 함께 출력된다.
STEP 1: training and writing data artifacts
STEP 2: starting local BentoML API and validating HTTP requests
STEP 3: reading CSV artifacts in another process and generating reports
Saved drift_normal.html and drift_normal.json
Saved drift_shifted.html and drift_shifted.json
LAB COMPLETE: reports and reproducibility evidence saved in artifacts/
마지막 줄이 나오면 모든 검증을 통과한 것이다. 스크립트는 API 예측이 모델의 직접 예측과 다르거나, 잘못된 입력에 400이 아닌 코드가 오거나, 드리프트 열 수가 대조군 0개·변형 데이터 3개가 아니면 오류로 중단하도록 작성했다. 중간에 멈췄다면 마지막으로 출력된 STEP 줄이 실패한 단계이고, API 문제라면 artifacts/server.log를 먼저 본다.
전체 흐름부터 정리하면 다음과 같다. 특히 5장 파이프라인은 4장에서 학습해 MLflow에 등록한 모델을 가져와 배치 추론을 수행한다.
4장: CSV 읽기 → 모델 3개 학습 → MLflow에 기록 → 모델 등록
4장: 피처 parquet 업로드 → Feast 정의 등록 → 과거/온라인 피처 조회
5장: 대상 사용자 읽기 → Feast 피처 조회 → 등록 모델로 예측 → parquet 저장
‘배치 추론’은 여러 입력을 한 번에 읽어 예측 결과를 파일로 남기는 방식이다. 사용자 요청 한 건마다 바로 응답하는 API 서버와는 실행 형태가 다르다.
세 도구를 다음처럼 나눠 보니 역할이 더 분명해졌다.
도구
이번 실습에서 답하는 질문
실제 남는 것
MLflow
어떤 설정으로 학습했고, 어떤 모델 파일을 쓸까?
실험 기록, 지표, 모델 버전
Feast
이 사용자의 피처를 어떤 데이터와 시각 기준으로 가져올까?
피처 정의, 과거 조회 결과, Redis의 피처 값
KFP
예측 작업들을 어떤 순서로 실행하고 파일을 넘길까?
실행 기록, 단계별 로그와 아티팩트
여기서 피처(feature)는 모델에 넣는 입력값이다. 이 예제에서는 학력, 직업, 관계 등의 정보를 사용한다. 아티팩트(artifact)는 실행 중 만들어진 파일을 뜻한다. 모델 파일, 그래프 PNG, 단계 사이에 전달되는 parquet 등이 여기에 해당한다.
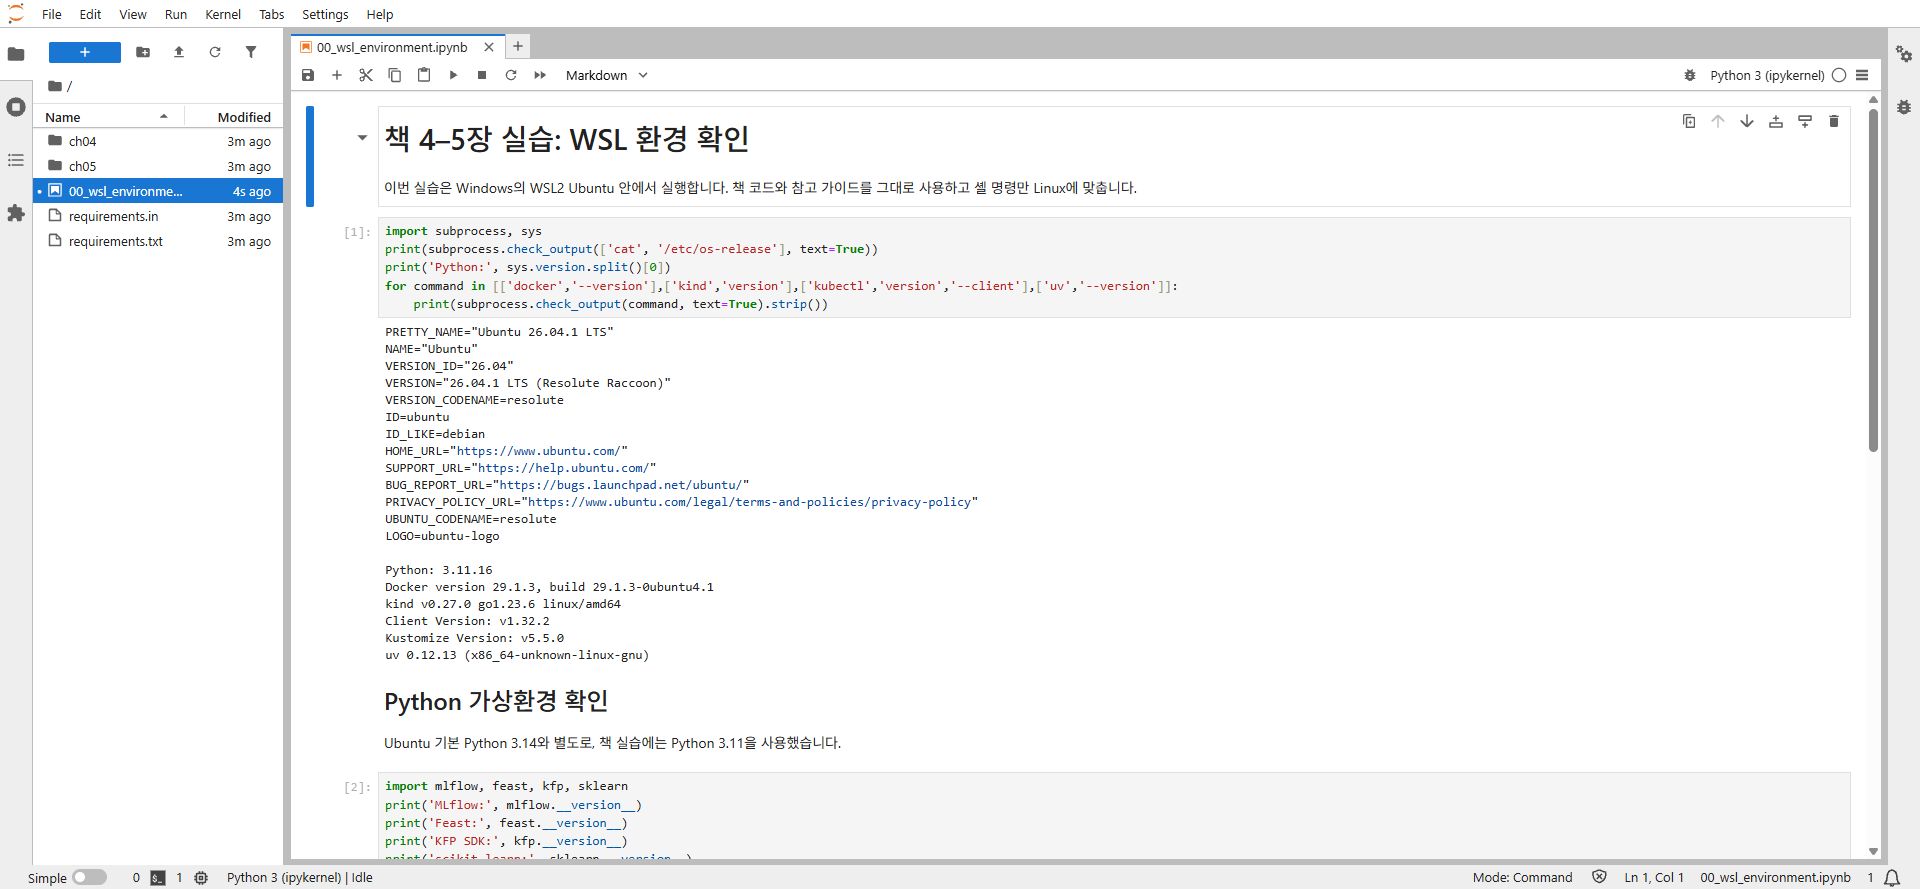
2. WSL 환경 준비: 기본 Python과 실습 Python을 분리
본인이 사용하는 WSL 환경에 이미 설치된 Python 3.14.4, git, uv와 실습 환경 간 충돌이 일어나지 않고, Docker, kind, kubectl은 WSL 환경에서 설치하지 않았기에, Docker Desktop 대신 Ubuntu 안에 Docker Engine을 설치하는 방식으로 준비했다.
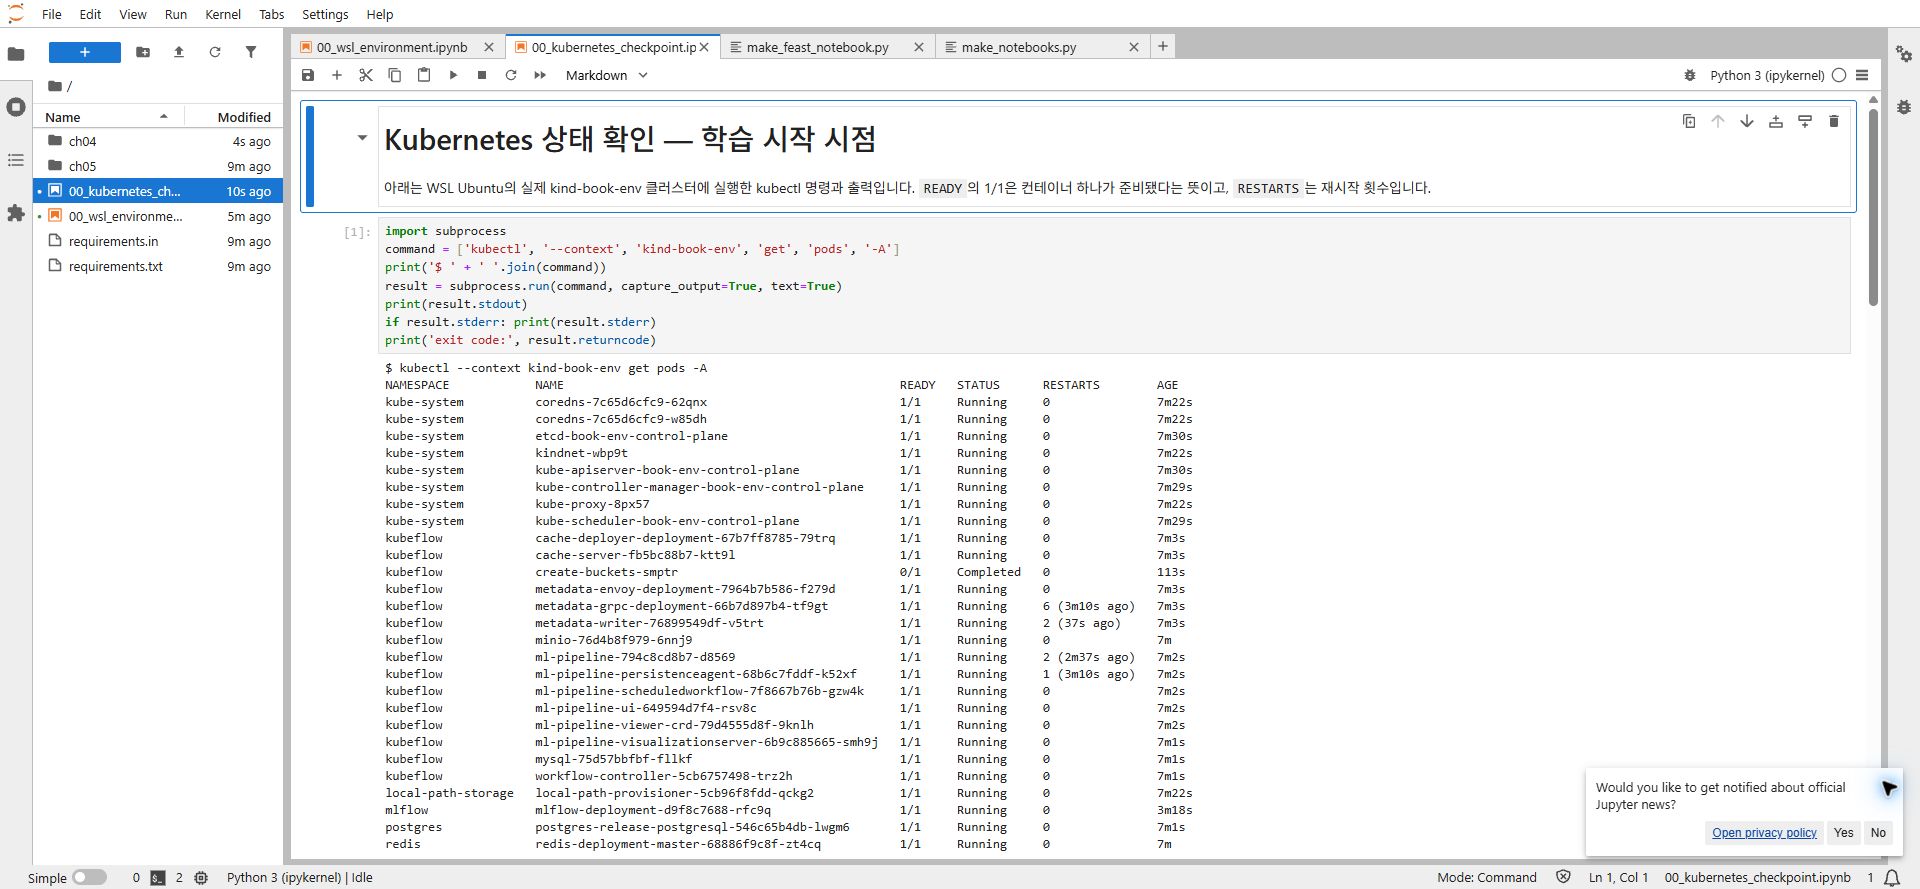
MySQL database was not initialized. Please ensure your MySQL server is running.
이때 MySQL Pod도 아직 ContainerCreating 상태였다. 이미지 다운로드와 데이터베이스 준비가 끝나기 전에 다른 서비스가 먼저 연결을 시도한 것이다. 바로 매니페스트나 DB 인증 설정을 바꾸기보다 의존 서비스가 준비됐는지 함께 확인했다.
MySQL이 준비된 뒤 재시작한 metadata 서비스도 1/1 Running으로 회복됐다. 이 경우 별도의 설정 수정이나 수동 Pod 재생성은 하지 않았다. 최종적으로 up의 마지막에 The environment is ready. Next: python bookenv.py forward가 출력됐다.
설치 완료 뒤 kubectl get pods로 확인한 서비스 상태
READY 1/1은 Pod의 컨테이너 하나가 준비됐다는 뜻이다. RESTARTS는 지금 장애라는 뜻이 아니라, 지금까지 재시작한 횟수다. 따라서 상태와 준비 여부를 함께 읽었다.
4. Windows 브라우저에서 WSL 서비스를 열기
별도 WSL 터미널에서 가상환경을 활성화하고 포트포워딩을 실행한다.
cd ~/project/ml-platform-lab/ml-platform-book-env
source .venv-book/bin/activate
python bookenv.py forward
포트포워딩은 PC의 특정 포트와 클러스터 안의 서비스 사이에 통로를 만드는 작업이다. 브라우저가 Kubernetes 서비스 주소를 직접 몰라도 localhost로 접속할 수 있게 해 준다.
브라우저 / 클라이언트 주소
용도
http://localhost:8080
KFP UI
http://localhost:5000
MLflow UI 및 API
http://localhost:8888/buckets/
SeaweedFS 저장소 화면
localhost:9000
S3 API
localhost:6379
Redis
JupyterLab은 저장소 화면의 8888과 겹치지 않도록 8890을 사용한다.
jupyter lab --notebook-dir book --port 8890 --ip 127.0.0.1 --no-browser
출력되는 토큰 포함 주소를 Windows 브라우저에서 열면 된다. 이번에는 WSL 서비스를 Windows Chrome에서 열어 확인했다.
버킷은 왜 여러 개 만들까
버킷은 S3 저장소에서 파일을 묶는 최상위 공간이다. 같은 저장소를 쓰더라도 학습 CSV, 모델 파일, 피처 정의, 최종 결과를 나눠 두면 어떤 단계가 무엇을 읽고 쓰는지 확인하기 쉽다.
첫 부분은 데이터 경로와 저장소 접속 설정을 준비한다. 이후 소득 분류 CSV를 읽고 범주별 분포를 살펴본다. 이번 데이터는 30,162행, 9개 열이었다.
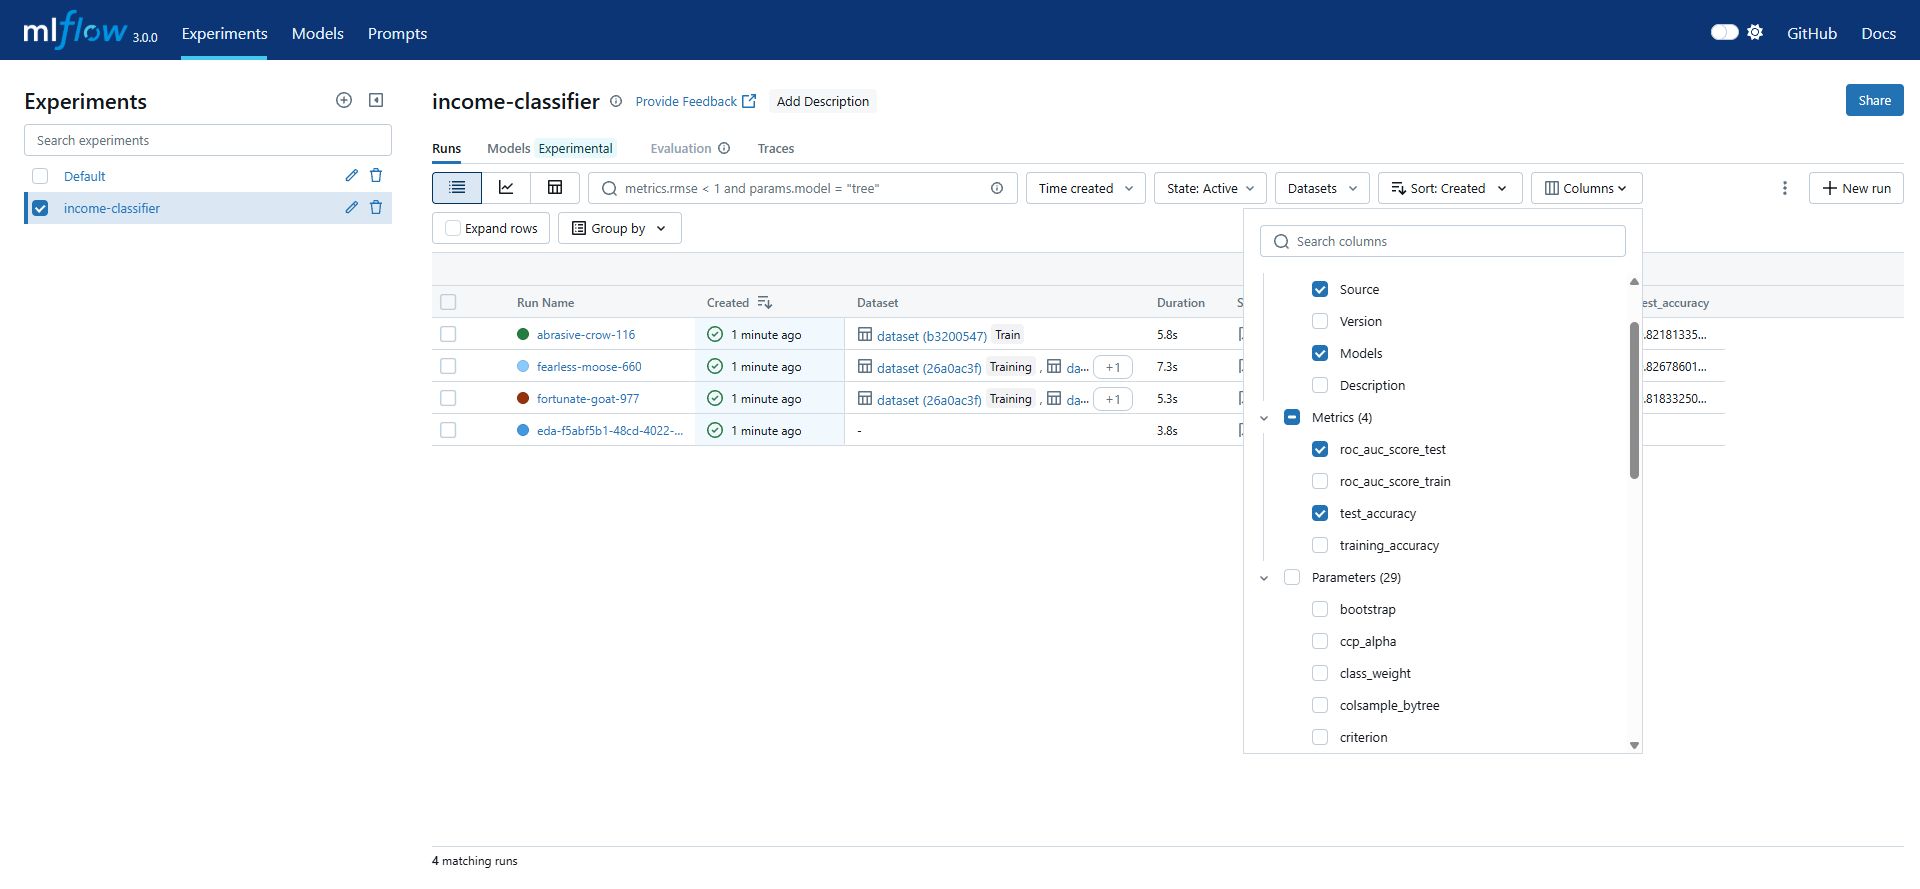
MLflow의 income-classifier Experiment 안에는 데이터 탐색 run 한 개와 모델 학습 run 세 개가 기록된다. Experiment는 관련 실행을 모아 두는 폴더와 비슷하고, Run은 그 안의 한 번의 실행 기록이다.
이번에 학습한 모델은 Decision Tree, Random Forest, XGBoost다. 학습 알고리즘은 scikit-learn과 XGBoost가 담당하고, MLflow는 설정·점수·파일을 기록한다.
모델
MLflow run
테스트 ROC AUC
테스트 정확도
Decision Tree
fortunate-goat-977
0.815114
0.818333
Random Forest
fearless-moose-660
0.857340
0.826786
XGBoost
abrasive-crow-116
0.718263
0.821813
ROC AUC는 분류기가 두 클래스를 얼마나 잘 구분하는지 살펴보는 지표다. 여기서는 값이 높을수록 좋게 본다. 다만 원본 코드는 데이터 분할과 일부 모델의 난수 시드를 고정하지 않는다. 같은 명령을 실행해도 이 글이나 참고 가이드와 점수가 정확히 일치하지 않을 수 있다.
또한 원본 XGBoost 셀은 마지막에 binary:hinge 모델의 0/1 예측으로 AUC를 계산한다. 다른 두 모델의 확률 기반 AUC와 같은 조건의 비교라고 해석하기는 어렵다. 이번 점수표는 책 코드가 남긴 결과를 확인한 기록이다.
이번 실행에서 MLflow에 기록된 탐색과 학습 run
모델 파일은 어디에 있을까
MLflow 화면에서 보이는 실행 이름, 설정, 지표 등은 PostgreSQL에 기록된다. 실제 모델과 그래프 파일은 mlflow-artifacts 버킷에 저장된다. 화면이 열린다고 모델 파일까지 정상적으로 저장됐다는 뜻은 아니므로 아티팩트도 확인해야 한다.
원본 노트북은 범주형 입력을 숫자 열로 바꾸고 column_list.pkl에 입력 열 순서를 저장한다. 예를 들어 학력과 직업을 여러 0/1 열로 바꾸면, 추론에서도 같은 열을 같은 순서로 넣어야 한다. 이 파일은 나중에 5장 추론 코드가 내려받는다.
모델 레지스트리에 등록
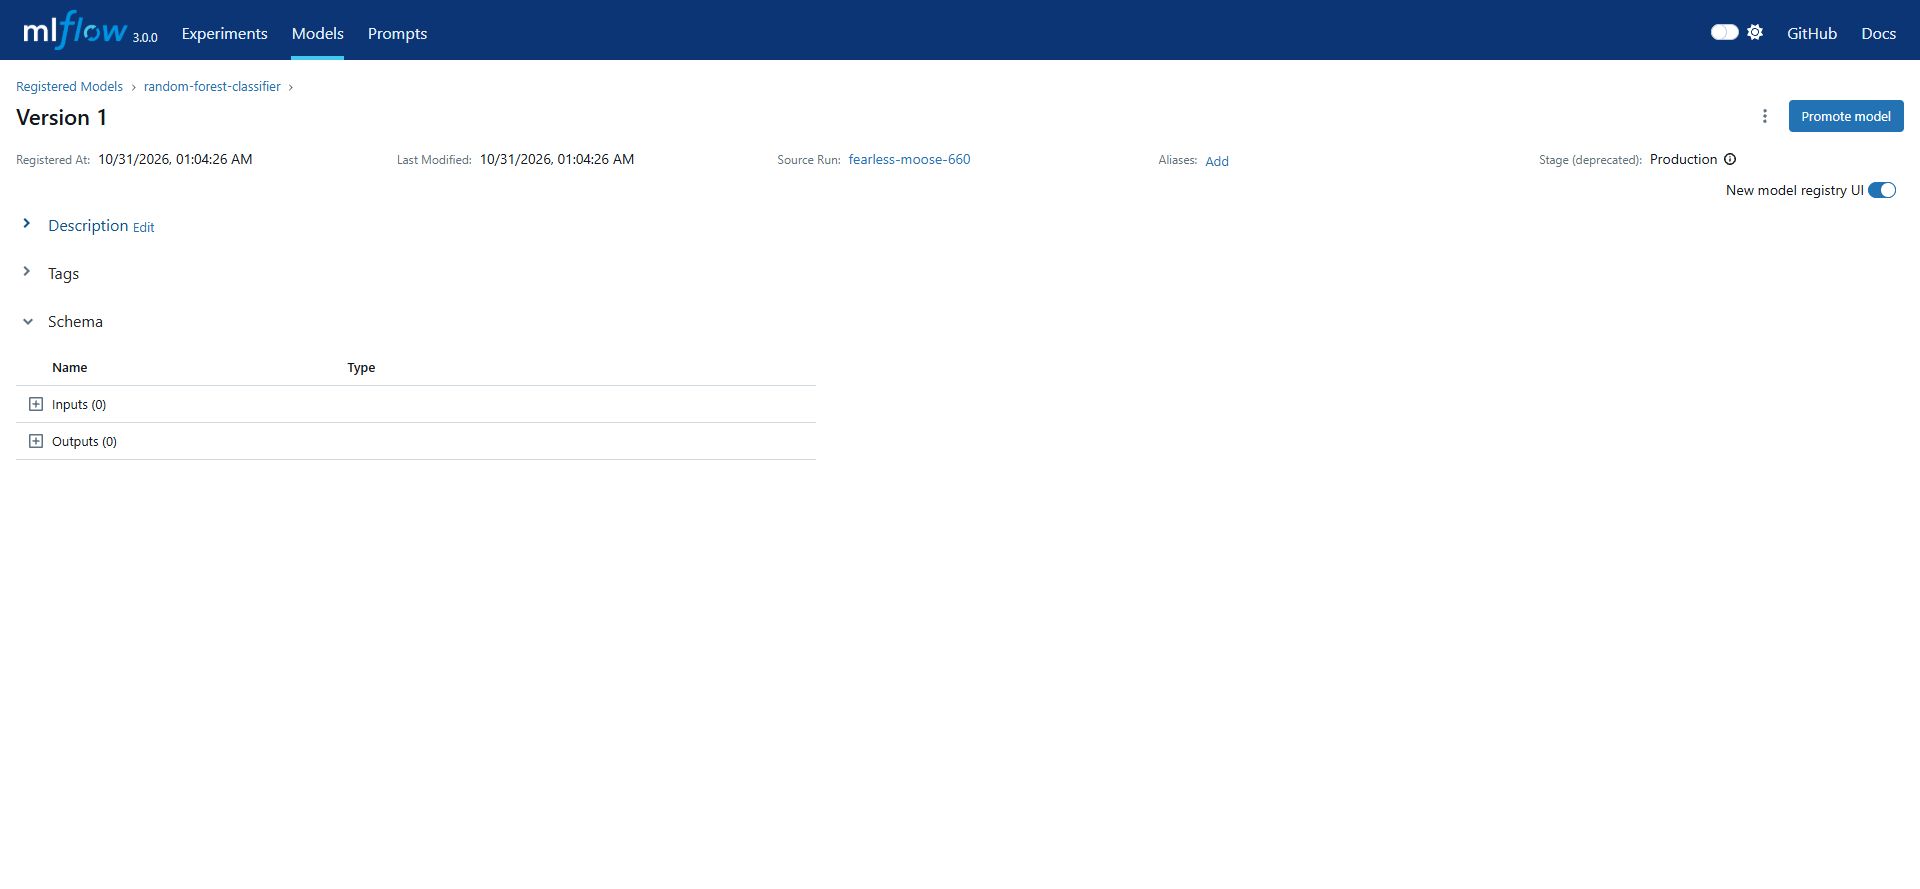
노트북 마지막 셀은 테스트 AUC가 높은 run을 찾아 random-forest-classifier라는 이름으로 등록한다. 이어서 가이드가 추가한 셀을 실행해 stage를 Production으로 지정한다.
이번에 선택된 원천 run은 fearless-moose-660였고, 테스트 AUC는 0.857340이었다. 모델은 버전 1 / Production으로 등록됐다. 원천 run ID는 489e1a27bc8b428c9b6f8fe9af0248e3다.
등록 모델의 버전과 원천 run
Production은 이번 코드가 모델 버전을 찾을 때 쓰는 표식이다. 이를 지정했다고 예측 API가 자동으로 배포되는 것은 아니다. MLflow 3에서는 stage 사용에 대한 FutureWarning이 나오지만, 이번 책 코드와의 연결에서는 실제로 동작하는지 확인했다.
6. 4장 Feast: 피처 정의와 피처 값을 구분하기
다음으로 ch04/02_feast_feature_store.ipynb를 실행했다.
학습 CSV를 읽는 것과 Feast를 사용하는 것은 서로 다른 과정이다. 이 책 예제의 학습 노트북은 CSV를 직접 읽고, Feast는 그 뒤에 따로 준비한다. 따라서 “학습도 처음부터 Feast로 했다”고 설명하면 이번 실행과 맞지 않는다.
이번 Feast 흐름은 다음과 같다.
원천 parquet 업로드
  → Entity / FeatureView 정의 등록
  → 과거 시점 피처 조회
  → Redis로 값 적재
  → 온라인 피처 조회
용어
쉽게 풀어 보면
이번 예제
Entity
누구의 값인지 찾는 키
user_id
FeatureView
함께 다룰 피처의 정의
demographic, relationship, occupation
Registry
피처의 이름·타입·위치 등을 기록한 목록
S3의 Registry 파일
Offline store
과거 피처를 읽는 원천
S3의 parquet
Online store
빠르게 조회할 최신값을 저장하는 곳
Redis
apply와 materialize는 다른 작업
feast apply는 피처 정의를 Registry에 등록하는 명령이다. 실행 로그에 세 FeatureView를 준비하는 메시지가 나타났다.
Deploying infrastructure for relationship
Deploying infrastructure for demographic
Deploying infrastructure for occupation
그렇다고 모든 피처 값이 Redis에 들어간 것은 아니다. feast materialize가 원천 데이터를 읽어 온라인 저장소로 옮긴다.
이 명령을 직접 실행한다면 노트북이 만든 book/ch04/feature_repo에서 실행해야 한다. 노트북의 도우미 셀은 이 작업 위치를 자동으로 지정한다.
과거 조회와 온라인 조회는 왜 나눌까
과거 조회는 사용자 ID와 예측하려는 기준 시각을 함께 사용한다. 그 시점에 맞는 피처를 가져오기 위해서다. 온라인 조회는 Redis에 적재된 최신값을 빠르게 가져오는 데 사용한다.
과거의 예측을 재현하면서 오늘의 최신값을 넣으면, 그때는 알 수 없었던 정보가 섞일 수 있다. 5장의 배치 추론이 get_historical_features()를 사용하는 이유도 이 구분과 연결된다.
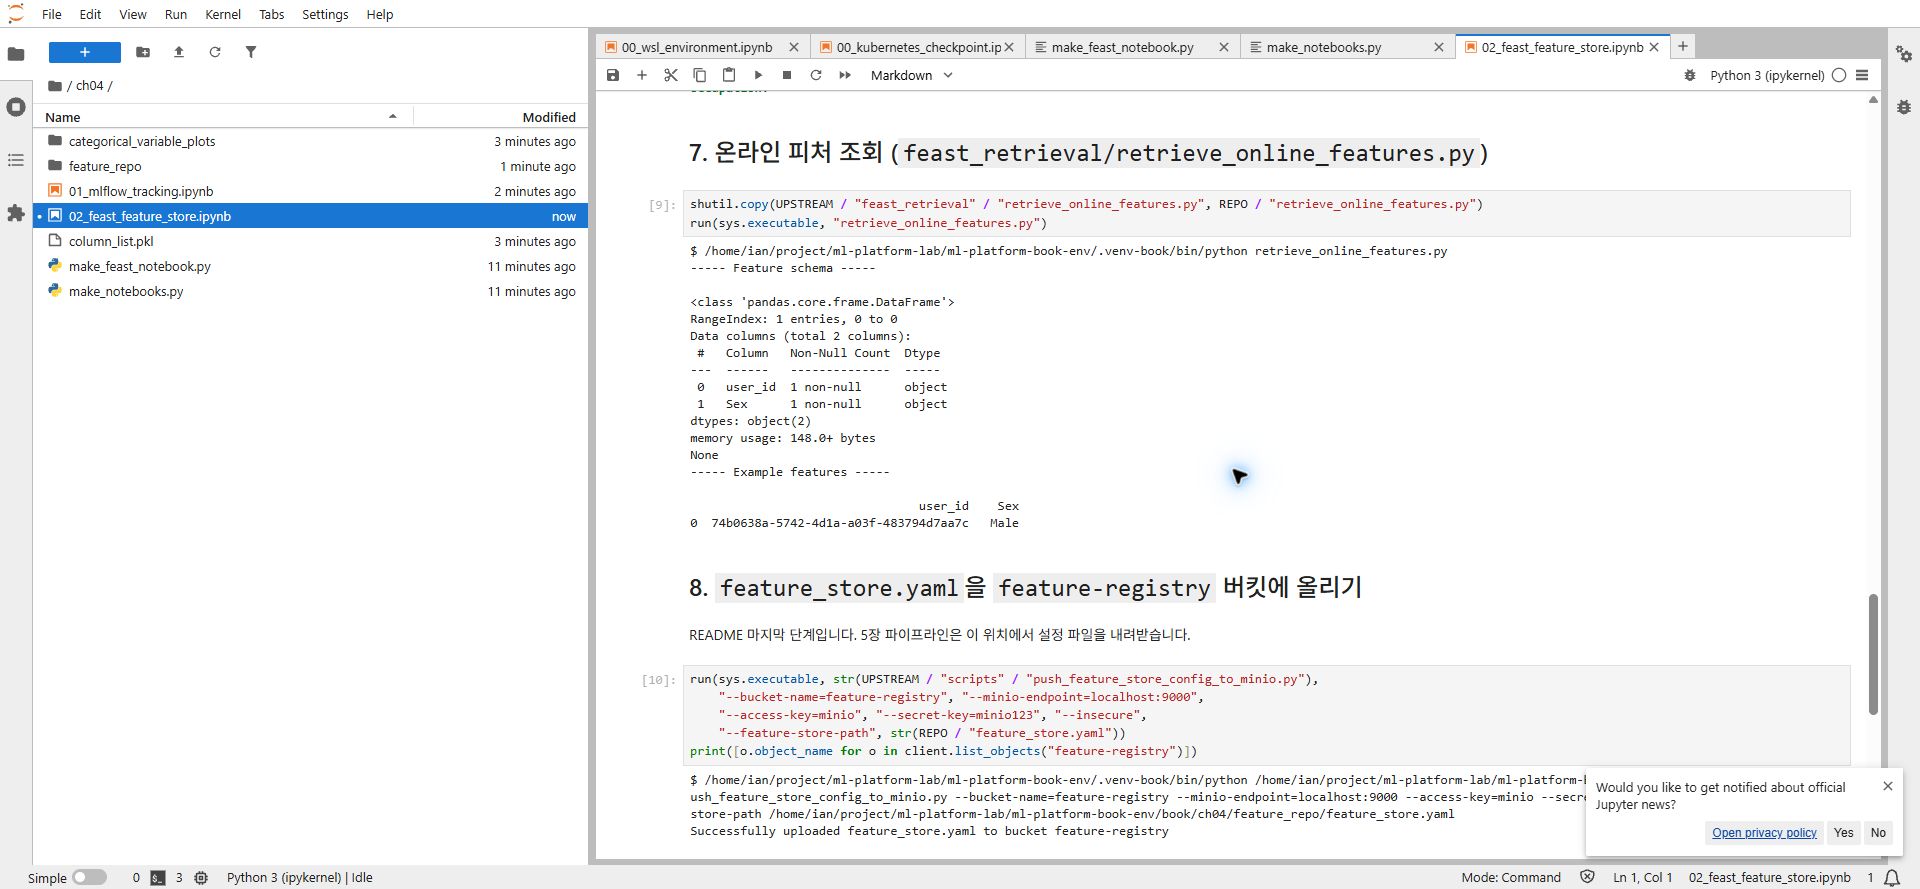
실제 과거 조회는 사용자 9f2ac416-06e1-44a0-87bd-d4787c85bf66의 2023-01-30 10:59:42+00:00 기준으로 Sex=Male을 반환했다. 온라인 조회는 원본 스크립트에 지정된 다른 사용자 74b0638a-5742-4d1a-a03f-483794d7aa7c에 대해 Sex=Male을 반환했다. 두 예제가 같은 사용자의 값 변화를 비교한 것은 아니다. 출력 중 None은 print(df.info())가 반환값을 출력한 부분이며, Sex가 결측이라는 의미가 아니다.
prepare.py는 원본 컴포넌트의 이미지 이름과 Redis 설정을 이 환경에 맞춘다. Docker로 이미지를 만드는 것과 kind 노드에 넣는 것은 별개다. 그래서 빌드 다음에 load를 실행했다.
참고 가이드의 Dockerfile은 오래된 Debian buster 기반 이미지를 bookworm으로 바꾸고, 추론 환경의 scikit-learn을 학습 환경과 같은 1.5.2로 맞춘다. 이 보완은 참고 가이드에 이미 들어 있는 변경이며, 이번 실습에서 새로 발견해 고친 것으로 소개하지 않는다.
feast-job은 Pod에서 사용할 피처 정의를 등록한다. upload_inputs.py는 클러스터용 설정과 예측 대상 파일을 올린다. 마지막 Python 명령은 파이프라인 정의를 실행용 YAML로 컴파일한다.
이번 이미지 참조는 네 컴포넌트 모두 book-ch5/components:0.1이었다. YAML이 만들어졌다는 것만으로 작업이 실행된 것은 아니다. 실제 실행은 KFP 서버에 등록하고 run을 시작한 뒤 확인해야 한다.
파이프라인 등록과 실행
참고 가이드는 UI에서 YAML을 업로드하고 실행한다. 이번에는 WSL의 Python SDK로 같은 YAML과 파라미터를 등록·제출하고, KFP UI에서 생성된 run과 그래프를 확인했다. 캐시를 끄고 실제로 네 컴포넌트를 실행했다.
import json
from pathlib import Path
import kfp

# 저장소 최상위 폴더에서 실행
client = kfp.Client(host="http://localhost:8080")
pipeline_id = client.get_pipeline_id("income-classifier-pipeline")
if not pipeline_id:
    pipeline = client.upload_pipeline(
        "upstream/chapter-5/income_classifier_pipeline.yaml",
        pipeline_name="income-classifier-pipeline",
    )
    pipeline_id = pipeline.pipeline_id

version = client.list_pipeline_versions(pipeline_id).pipeline_versions[0]
experiment = client.create_experiment("income-classifier")
params = json.loads(Path("book/ch05/run-parameters.json").read_text())
run = client.run_pipeline(
    experiment.experiment_id,
    "income-classifier-wsl-run-1",
    pipeline_id=pipeline_id,
    version_id=version.pipeline_version_id,
    params=params,
    enable_caching=False,
)
print(run.run_id)
SDK로 등록된 파이프라인을 실행하는 과정에서는 다음 오류도 만났다.
both `pipeline_id` and `version_id` are required
내 제출 코드에서 파이프라인 ID만 전달했기 때문이다. 등록된 파이프라인의 버전 ID도 조회해서 run_pipeline()에 함께 전달하니 run이 만들어졌다. 이 오류는 이번에 추가한 SDK 제출 코드의 문제였으며, 책의 추론 컴포넌트가 실패한 것은 아니다.
핵심 파라미터는 다음과 같다. 나머지 값은 가이드의 book/ch05/run-parameters.json을 사용했다.
파라미터
값
대상 파일
feature-data-sets/entity_df.parquet
Feast 설정
feature-registry/feature_store_k8s.yaml
모델 이름 / stage
random-forest-classifier / Production
출력 파일
inference-datasets/income_predictions.parquet
KFP의 Experiment와 MLflow의 Experiment는 이름이 같아도 별개다. 전자는 파이프라인 실행을, 후자는 모델 학습 기록을 묶는다.
실제로 실행되는 네 단계는 아래와 같다.
단계
무엇을 하는가
read-data-from-minio
예측 대상 사용자와 기준 시각을 읽는다
retrieve-features-from-feast
대상에 맞는 과거 피처를 조회한다
model-inference
MLflow 등록 모델과 입력 열 목록을 받아 예측한다
write-data-to-minio
예측 결과를 최종 버킷에 저장한다
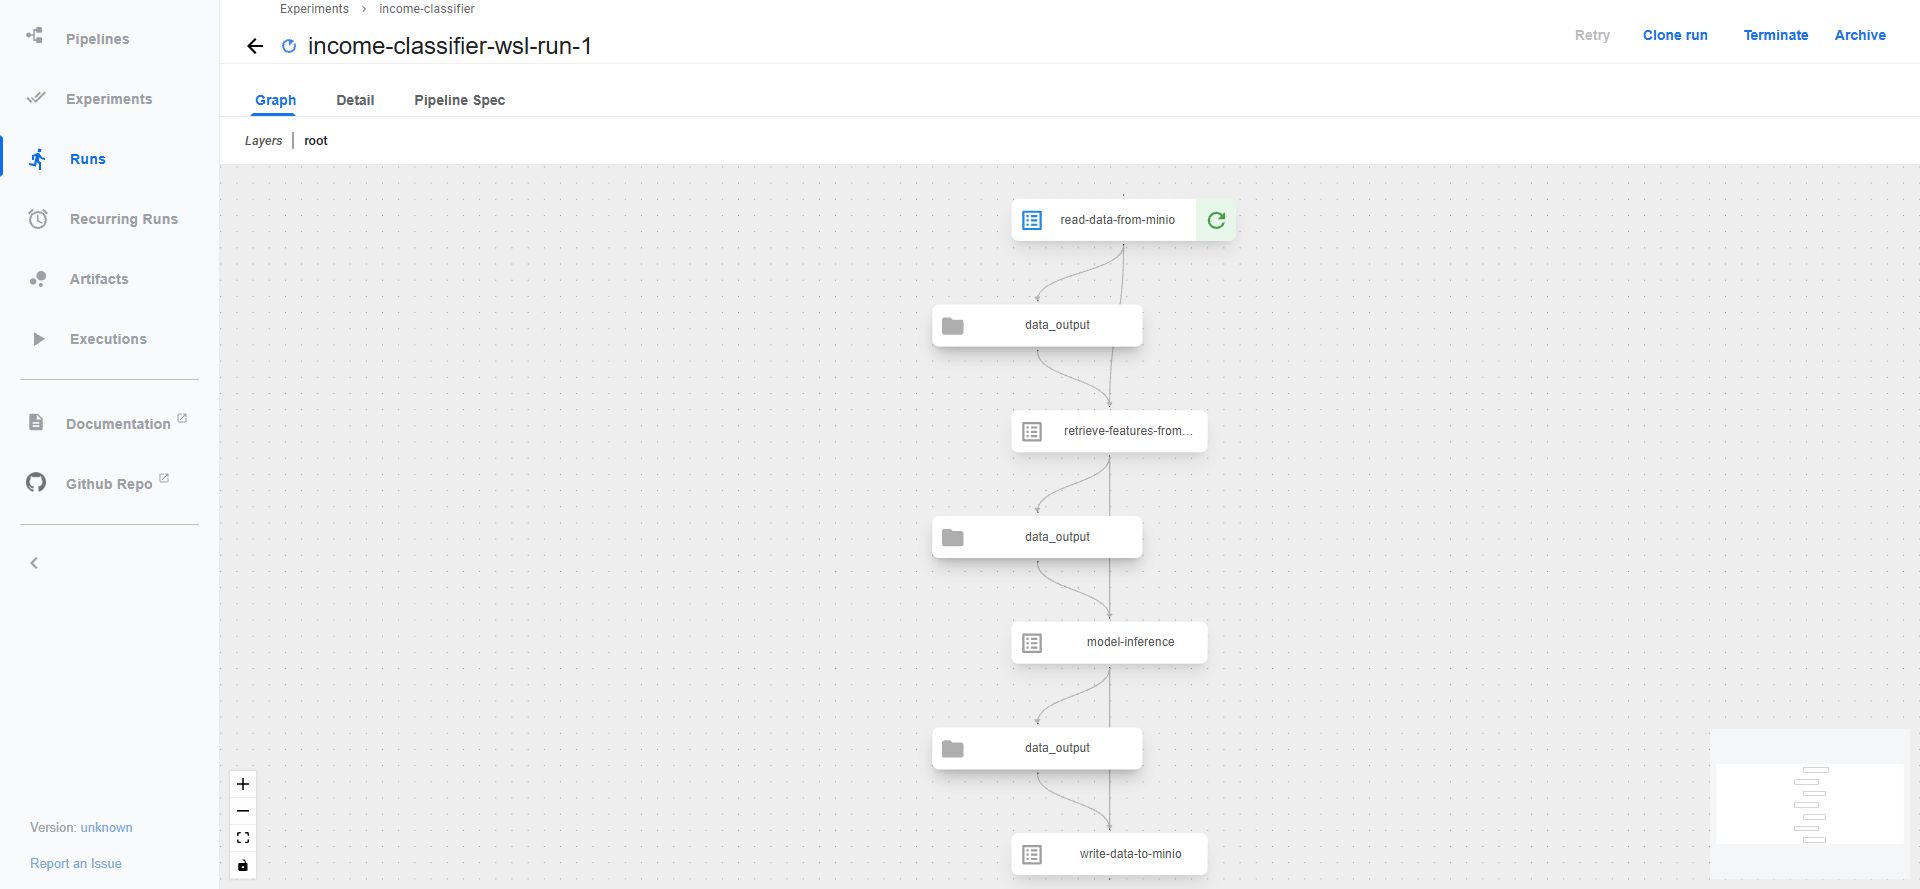
KFP는 앞 단계의 Python 메모리를 다음 단계와 공유하지 않는다. 각 작업은 별도 Pod에서 실행되고 중간 결과는 파일로 전달된다. 화면의 화살표는 작업 순서뿐 아니라 파일 입력·출력의 연결로 읽어야 한다.
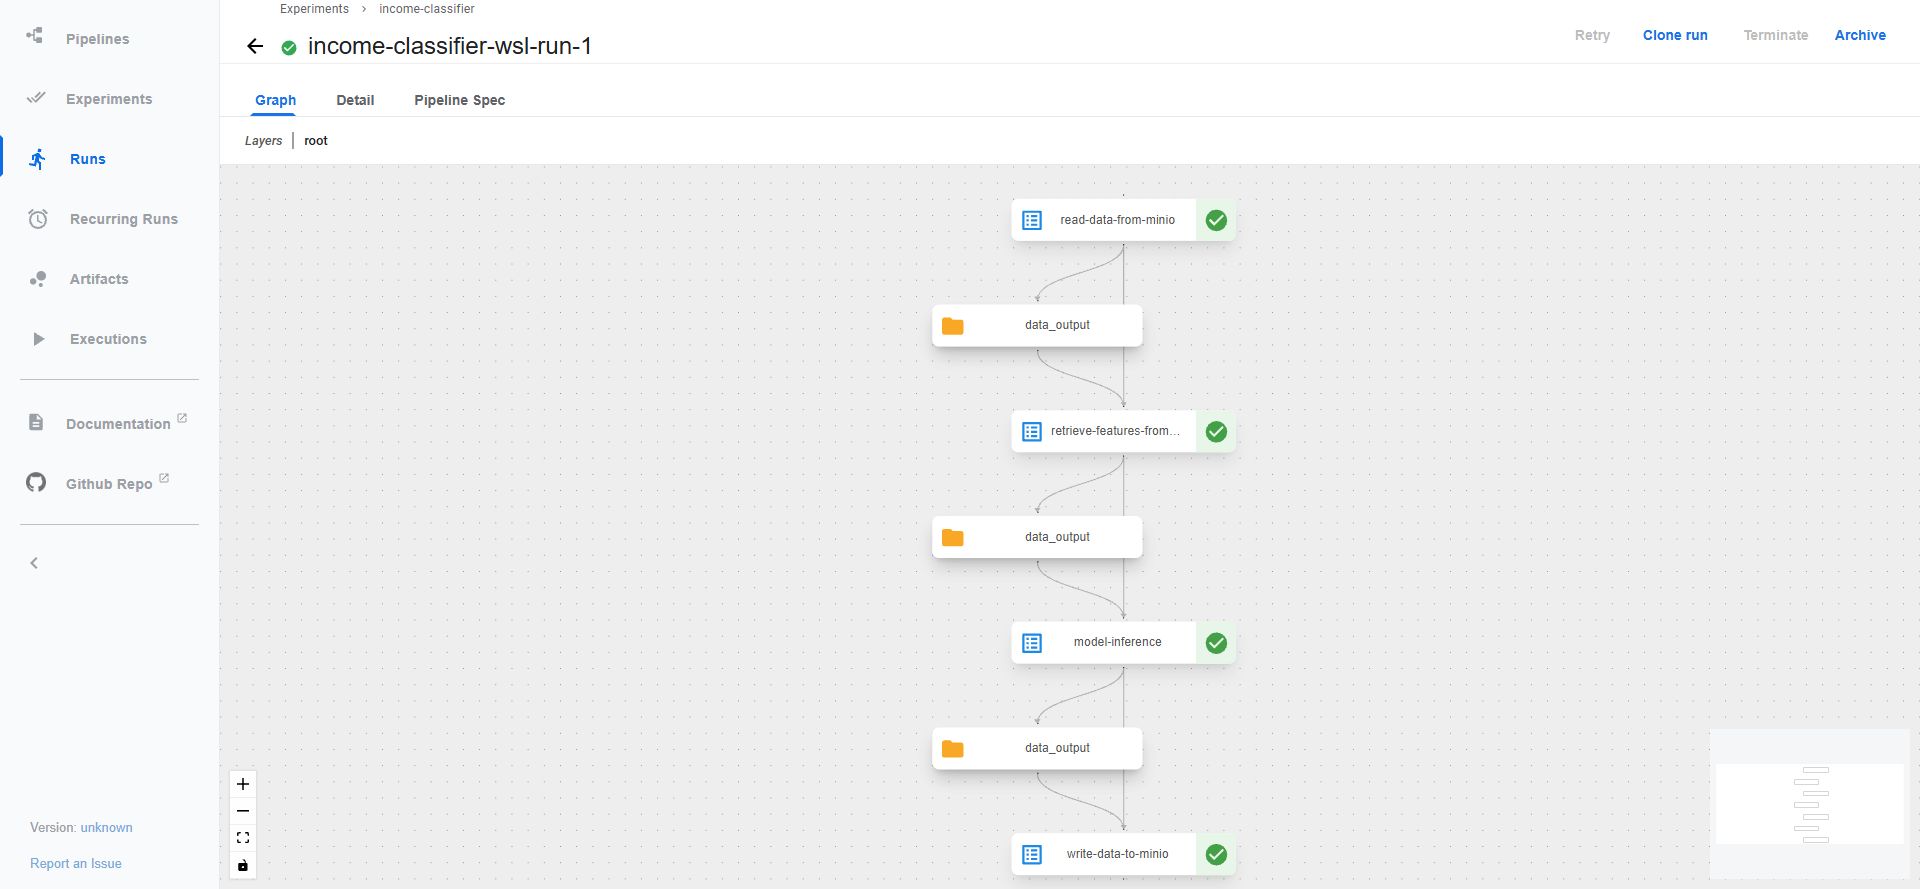
이번 run ID는 06e5dad7-2ae6-4e46-95aa-1379f72e5a58다. KFP 화면에서는 네 컴포넌트가 모두 초록색 체크로 바뀌었고, kubectl get workflows에서는 income-classifier-pipeline-j4b4j이 Succeeded로 표시됐다.
파이프라인이 실행 중일 때는 첫 컴포넌트가 동작하는 모습을 확인할 수 있었다.
실행 중인 KFP 파이프라인
이번 WSL 클러스터에서 실행한 KFP 배치 추론 그래프
UI와 kubectl을 함께 확인
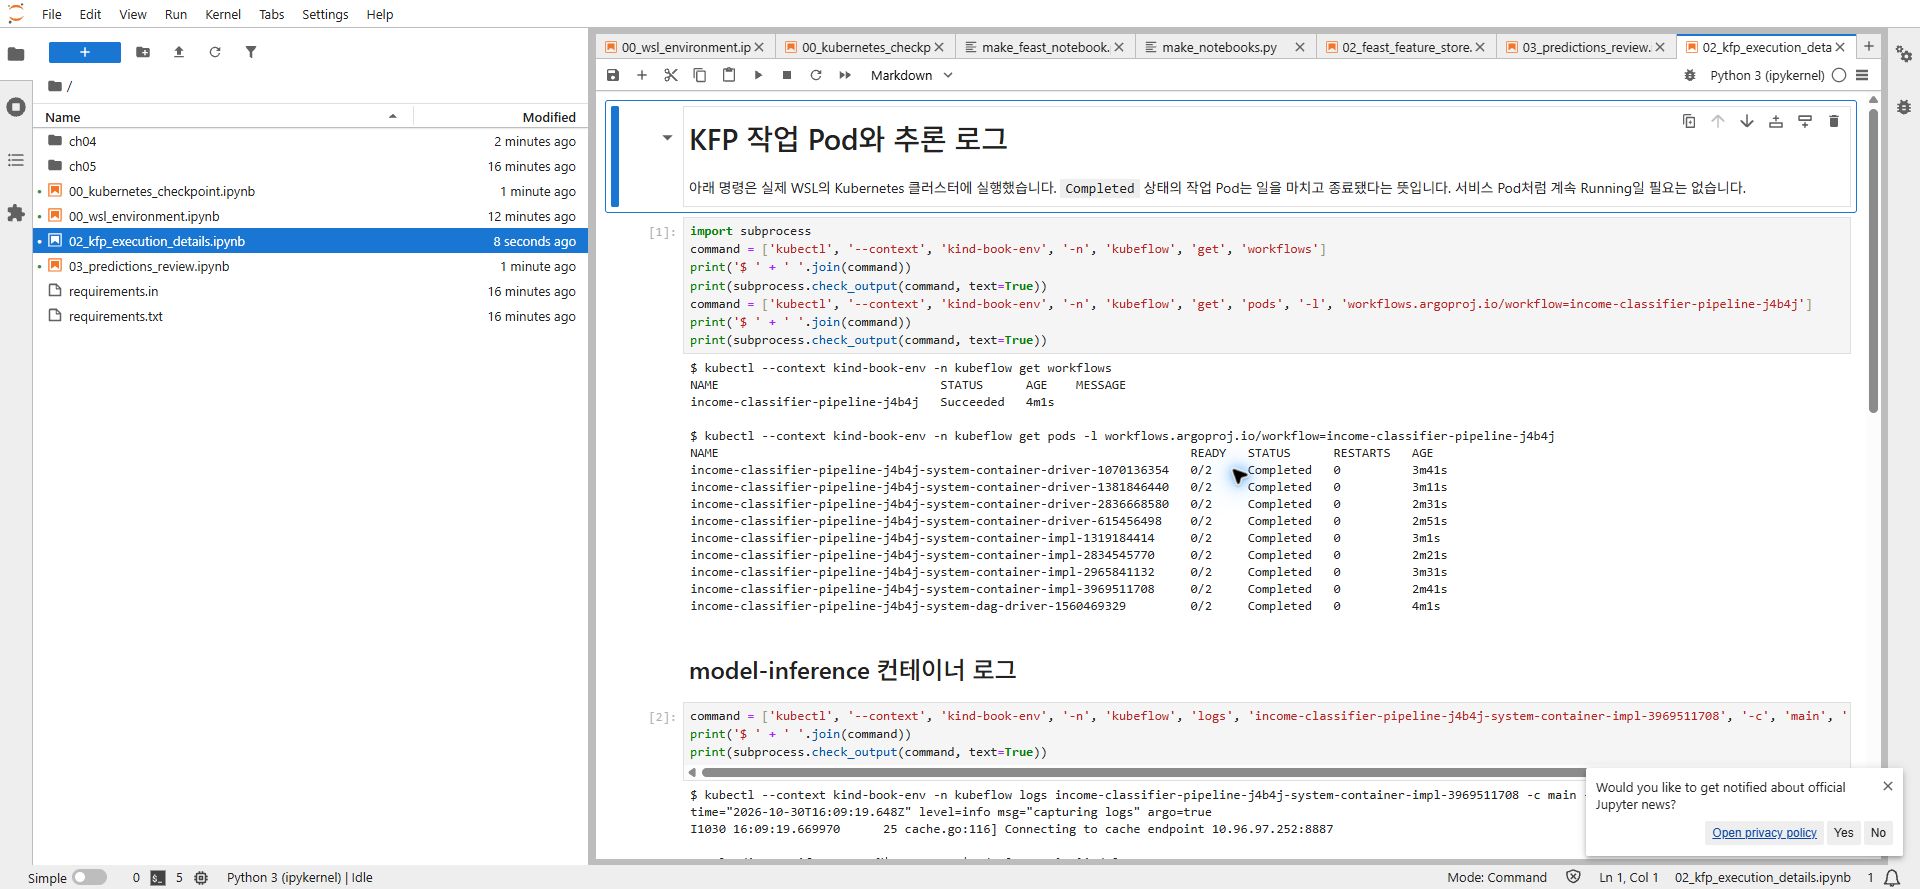
실행 중과 완료 뒤에는 아래 명령도 조회했다. Workflow 이름은 이번 실행에서 생성된 실제 이름이다. 다른 실행에서는 get workflows 결과에서 자신의 이름을 확인해 넣으면 된다.
kubectl --context kind-book-env -n kubeflow get workflows
kubectl --context kind-book-env -n kubeflow get pods \
  -l workflows.argoproj.io/workflow=income-classifier-pipeline-j4b4j
kubectl --context kind-book-env -n kubeflow get jobs
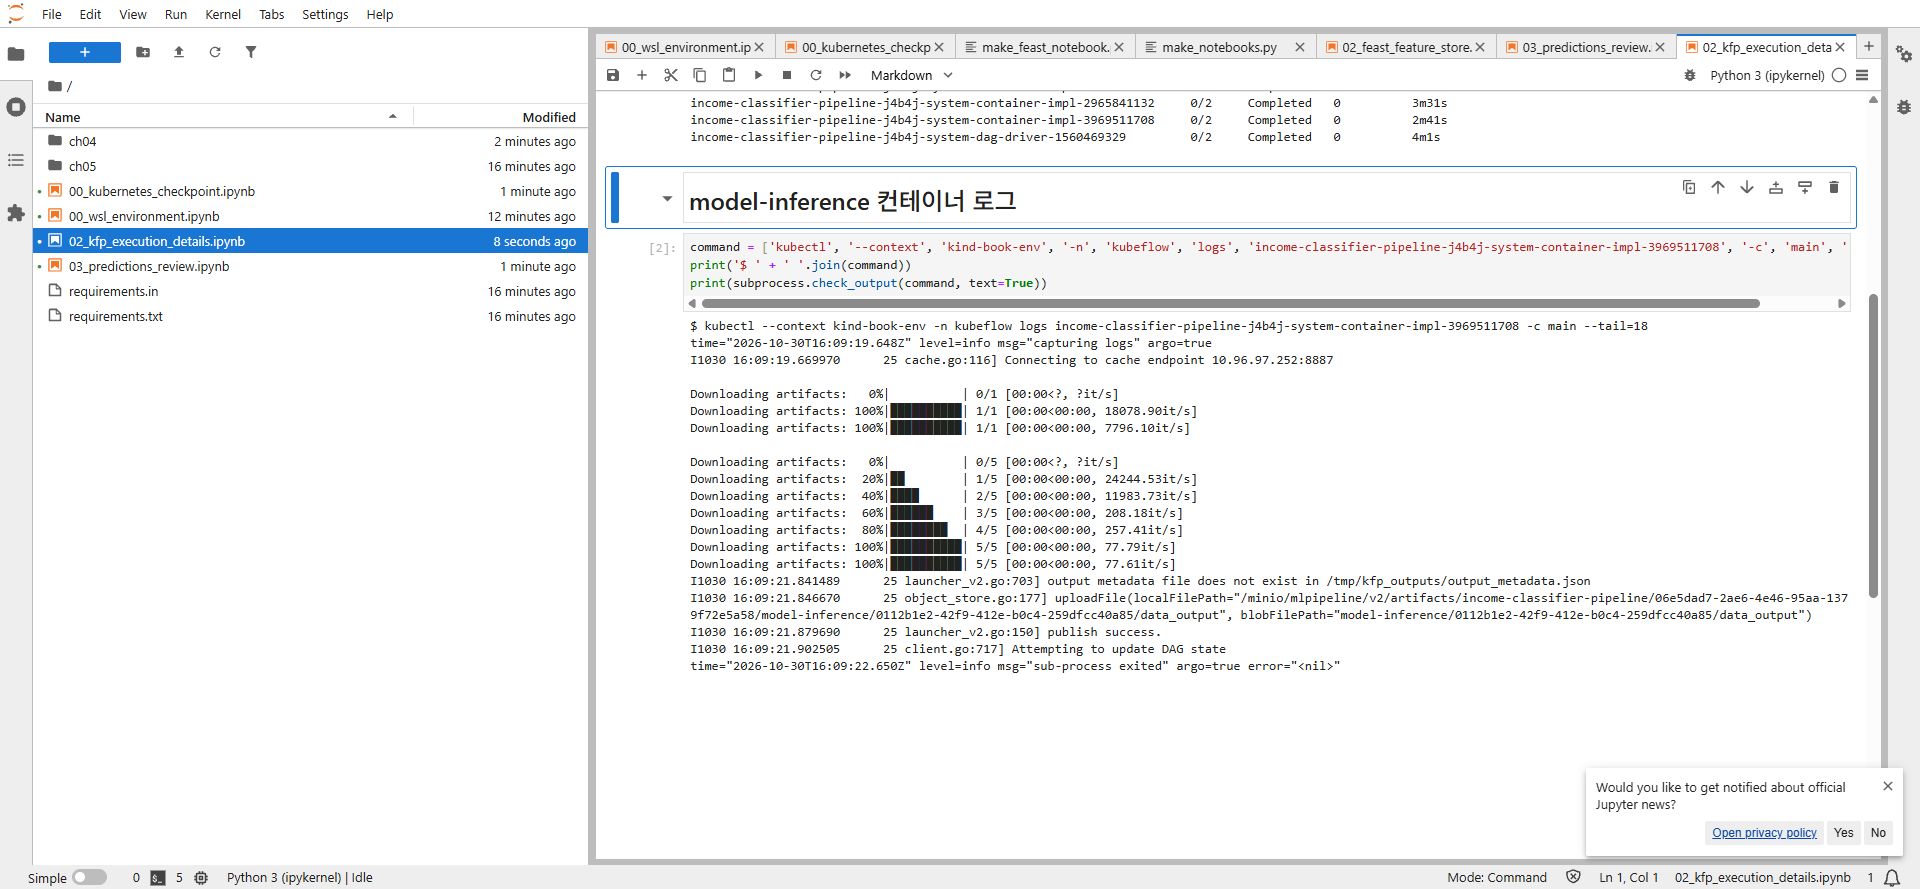
kubectl에서 확인한 Workflow 성공과 작업 Pod 완료
작업 Pod들은 0/2 Completed로 표시됐다. 실패해서 준비가 안 된 것이 아니라, 두 컨테이너가 할 일을 마치고 종료됐기 때문이다. MLflow 서버처럼 계속 실행되는 서비스 Pod와 다르게 읽어야 한다.
로그에서는 아티팩트 다운로드, 추론 결과 파일 업로드, publish success, sub-process exited와 error="<nil>"을 확인했다. 특정 로그 한 줄만으로 성공을 판단하지 않고, Workflow 상태와 최종 결과 파일까지 함께 확인했다.
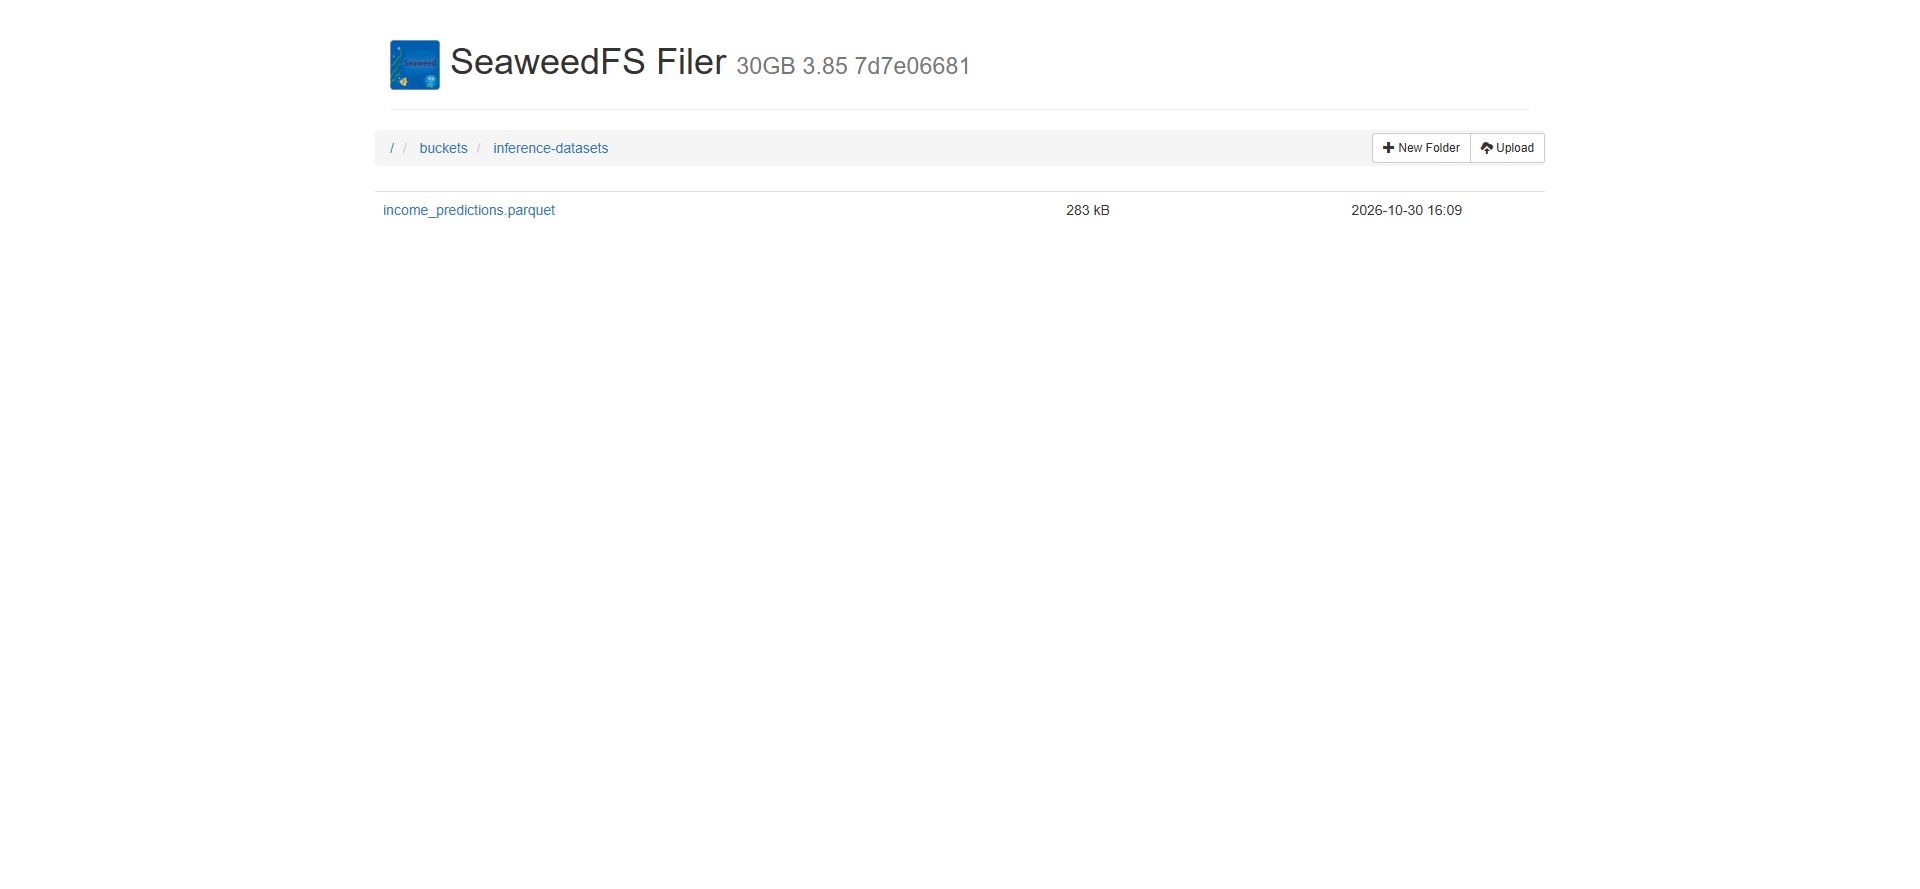
9. 성공 표시 다음에 실제 파일 확인
KFP 화면에 초록색 체크가 나타나도, 마지막 버킷에 원하는 결과가 저장됐는지까지 확인해야 한다.
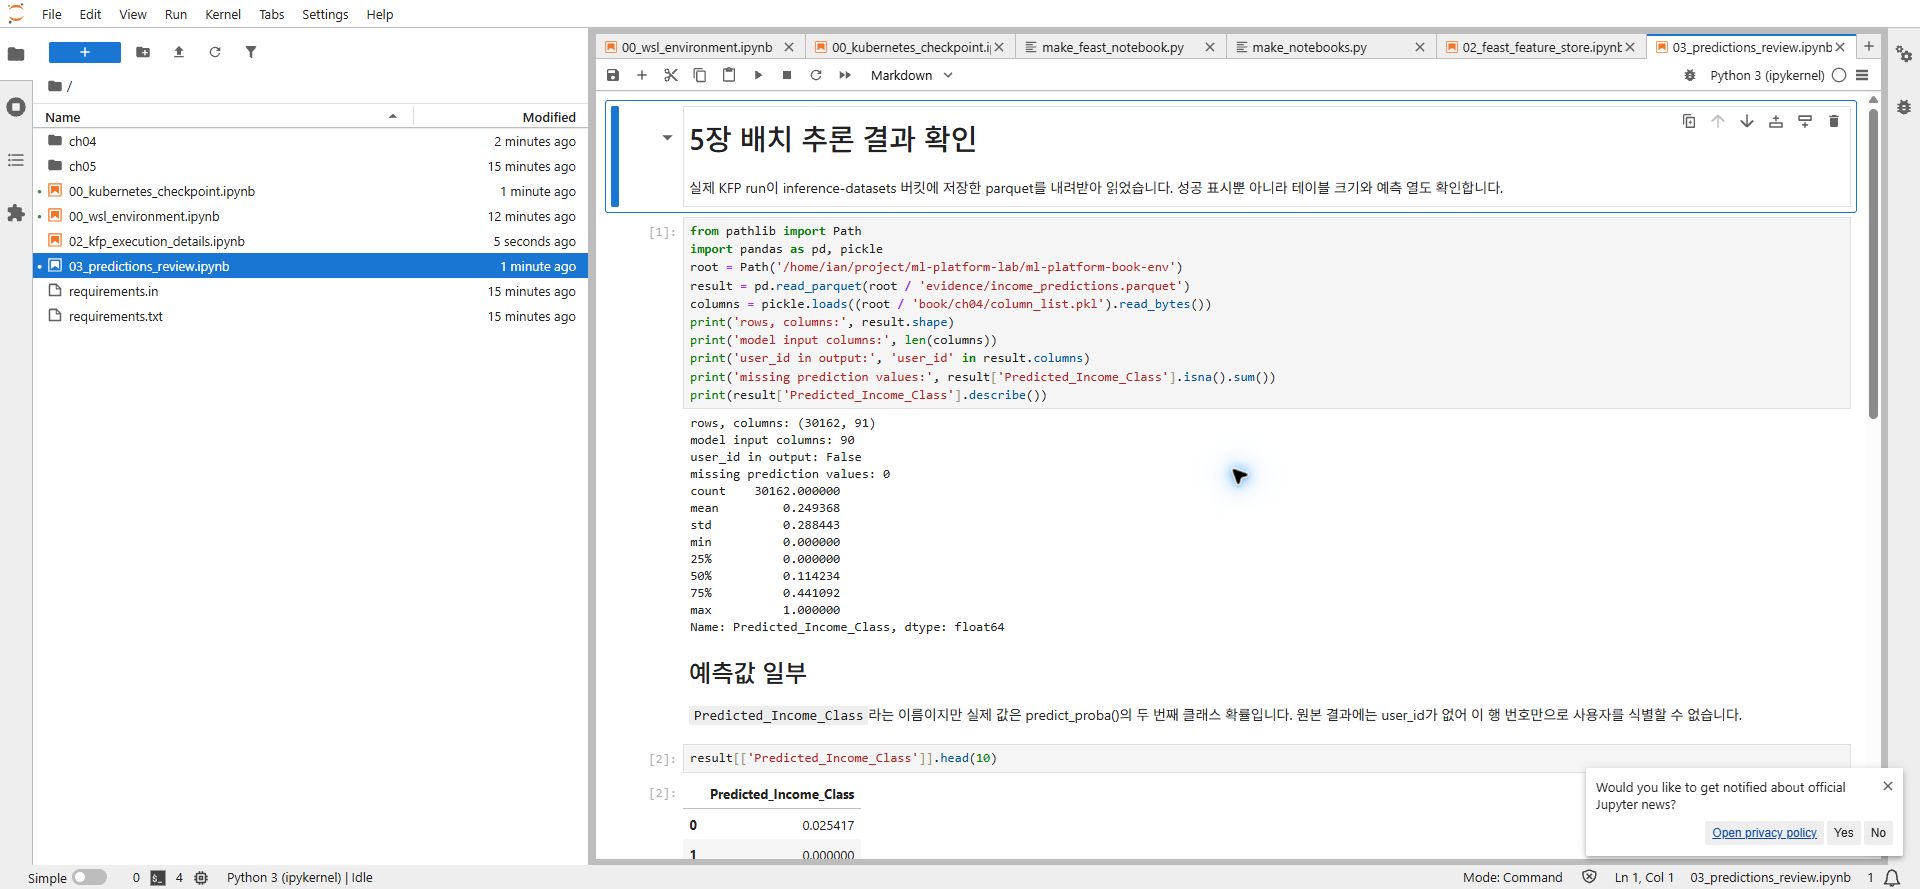
python book/ch05/show_predictions.py
이번 파일을 읽은 결과는 다음과 같았다.
rows, columns: (30162, 91)
model input columns: 90
user_id in output: False
missing prediction values: 0
파일 크기는 282,569바이트였다. 예측값의 범위는 0.0–1.0, 평균은 약 0.2494였다. 평균값은 이 파일의 요약 통계이며, 정확도나 모델 품질 지표는 아니다.
참고 가이드에는 92열이라고 되어 있지만 이번 실행은 91열이었다. 저장된 column_list.pkl에는 모델 입력 열이 90개 있고, 결과는 그 입력 열에 예측 열 하나가 더해진 구조였다. 참고 글의 숫자를 옮기지 않고 이번 파일에서 측정한 값으로 기록했다.
최종 버킷에 저장된 이번 실행의 예측 파일
parquet를 읽어 확인한 결과와 데이터 크기
parquet는 테이블 데이터를 저장하는 바이너리 형식이다. 웹 화면에서 파일을 텍스트로 열었을 때 깨진 문자나 PAR1이 보인다고 곧바로 파일이 손상됐다고 판단하면 안 된다. pandas 등으로 실제 테이블을 읽어 확인하는 편이 정확하다.
실행 성공과 결과를 업무에 쓸 수 있다는 것은 별개
이번 원본 결과에는 user_id가 없었다. 추론 코드가 모델 입력에서 ID를 제거하고 결과에 다시 붙이지 않기 때문이다. 모델 입력에서 ID를 빼는 것과 예측 결과의 사용자를 식별할 수 없게 만드는 것은 다른 문제다.
실제 서비스 결과라면 사용자 ID, 기준 시각, 구체 모델 버전도 함께 남기도록 보완해야 한다.
예측 열 이름은 Predicted_Income_Class지만 원본 코드는 predict_proba()의 두 번째 클래스 값을 넣는다. 따라서 0.7 같은 값은 클래스 번호가 아니라 확률 추정치다. 확률을 0/1 판단으로 바꾸는 임계값 설정은 이번 코드에 포함되어 있지 않다.
원본 코드는 테스트 점수로 모델을 선택한다. 운영용 모델 선택에서는 검증셋으로 후보를 고르고 테스트셋은 최종 확인에 사용하는 방식을 별도로 검토할 필요가 있다. 이번 실습에서 예측 파일을 만들었다는 사실만으로 모델의 일반화 성능이나 업무 적합성까지 검증한 것은 아니다.
10. 이번 WSL 실습에서 확인한 점
이번 실행은 책의 모델 학습, 피처 준비, 배치 추론 흐름을 WSL에서도 연결할 수 있는지 확인하는 데 초점을 맞췄다.
Ubuntu 안에 Docker Engine과 CLI 도구를 준비하고, Python 3.11 가상환경에서 책의 노트북 두 개를 실행했다. MLflow의 네 run과 등록 모델, Feast의 과거·온라인 조회, KFP의 네 작업 성공, S3의 최종 예측 파일까지 확인했다. WSL에서 추가로 필요한 준비와 실행 위치에 따른 주소 차이를 함께 확인할 수 있었다.
내가 다시 설명할 수 있어야 할 포인트는 다음과 같다.
MLflow는 모델을 대신 학습하는 도구가 아니라, 학습 설정·결과·모델 파일을 추적하는 도구다.
Feast의 Registry에 정의가 있다고 Redis에 값까지 들어 있는 것은 아니다. apply와 materialize를 구분해야 한다.
과거 조회에는 기준 시각이 필요하다. 최신 온라인 값과 과거 시점의 값은 사용 목적이 다르다.
WSL 노트북과 Kubernetes Pod는 접속 주소가 다르다. localhost를 복사하기 전에 실행 위치를 확인해야 한다.
KFP 성공 표시 이후에도 최종 파일의 크기, 내용, 사용자 식별 열을 확인해야 한다.
세 도구를 각각 설치하는 것보다, 모델과 데이터가 어디에 남고 다음 단계가 어떤 주소와 파일 이름으로 가져가는지 확인하는 과정이 이번 스터디의 핵심이었다.
다시 실행하거나 종료할 때
환경은 결과를 다시 확인할 수 있도록 남겨 두었다. 다시 접속하려면 클러스터 상태를 확인하고 forward와 JupyterLab을 실행한다.
cd ~/project/ml-platform-lab/ml-platform-book-env
source .venv-book/bin/activate
python bookenv.py status
python bookenv.py forward
다른 터미널에서:
cd ~/project/ml-platform-lab/ml-platform-book-env
source .venv-book/bin/activate
jupyter lab --notebook-dir book --port 8890 --ip 127.0.0.1 --no-browser
Ctrl+C로 포트포워딩이나 JupyterLab을 멈추면 접속 프로세스가 종료된다. 클러스터를 삭제하는 python bookenv.py down은 내부 실습 기록도 지우므로, 이 글의 결과를 확인하기 위해 이번에는 실행하지 않았다.